Aprendizaje Automático Ingeniero: Guía Completa para Desplegar Modelos en Producción
Del Jupyter Notebook al sistema que genera valor: habilidades, herramientas y un caso real de despliegue con Python y Flask.
Por Jose Luis Rueda · 14 min lectura · 2026-08-07
Las empresas acumulan datos sin pausa. Pero los datos no generan ventaja competitiva por sí solos: el verdadero valor aparece cuando los modelos predictivos se traducen en acciones automáticas, recomendaciones personalizadas o alertas tempranas. Ahí entra el Ingeniero de Aprendizaje Automático, el profesional que convierte un prototipo de laboratorio en una pieza de software robusta y escalable.
Si usted ya entrena modelos con scikit-learn en un notebook, ha cubierto la primera etapa. Llevar ese modelo a un entorno productivo exige ir más allá del accuracy: infraestructura, monitoreo, versionado y una mentalidad de ingeniería de software. Esta guía recorre las responsabilidades reales del rol, las herramientas que dominan el mercado y un ejemplo detallado para desplegar un clasificador con Python y Flask, desde cero.
No encontrará aquí teorías vacías ni listas interminables de librerías. Cada sección está pensada para profesionales que buscan resultados concretos, con los pies en la realidad de los sistemas en producción.
Qué hace realmente un Ingeniero de Aprendizaje Automático
El puesto de Machine Learning Engineer (MLE) nació para resolver un problema recurrente: los científicos de datos creaban modelos excelentes en entornos controlados, pero esos modelos morían en un disco duro o en un repositorio de código sin llegar a impactar al negocio. El MLE se encarga de industrializar el aprendizaje automático. Esto incluye diseñar pipelines de datos, empaquetar modelos, desplegarlos como servicios, monitorear su comportamiento y automatizar el reentrenamiento cuando el rendimiento decae.
Un buen MLE domina Python y entiende de estadística, pero también sabe de APIs REST, contenedores, orquestación, CI/CD y gestión de infraestructura en la nube. No es un data scientist que aprendió a usar Flask un fin de semana; es un ingeniero de software especializado en sistemas que aprenden. En el día a día, traduce los requisitos de negocio en decisiones técnicas: ¿necesitamos inferencia en tiempo real o basta con predicciones por lotes cada noche?, ¿qué latencia tolera la aplicación cliente?, ¿cómo versionamos el modelo junto con los datos de entrenamiento?
Del notebook a producción: el ciclo de vida real
El camino típico de un proyecto de ML en producción difiere bastante del CRISP-DM académico. En lugar de una secuencia lineal de fases, el MLE opera con ciclos iterativos y mucha ingeniería alrededor del modelo. Las etapas clave son:
- Experimentación controlada: análisis exploratorio, selección de features y entrenamiento de modelos candidatos, todo con datos históricos en un entorno aislado.
- Empaquetado del modelo: serialización eficiente (joblib, pickle u ONNX), envoltura en una clase con interfaz predecible y tests unitarios para validar entradas y salidas.
- Despliegue: exposición del modelo a través de una API, un sistema de mensajería o un trabajo batch programado. Aquí se definen recursos, escalado y seguridad.
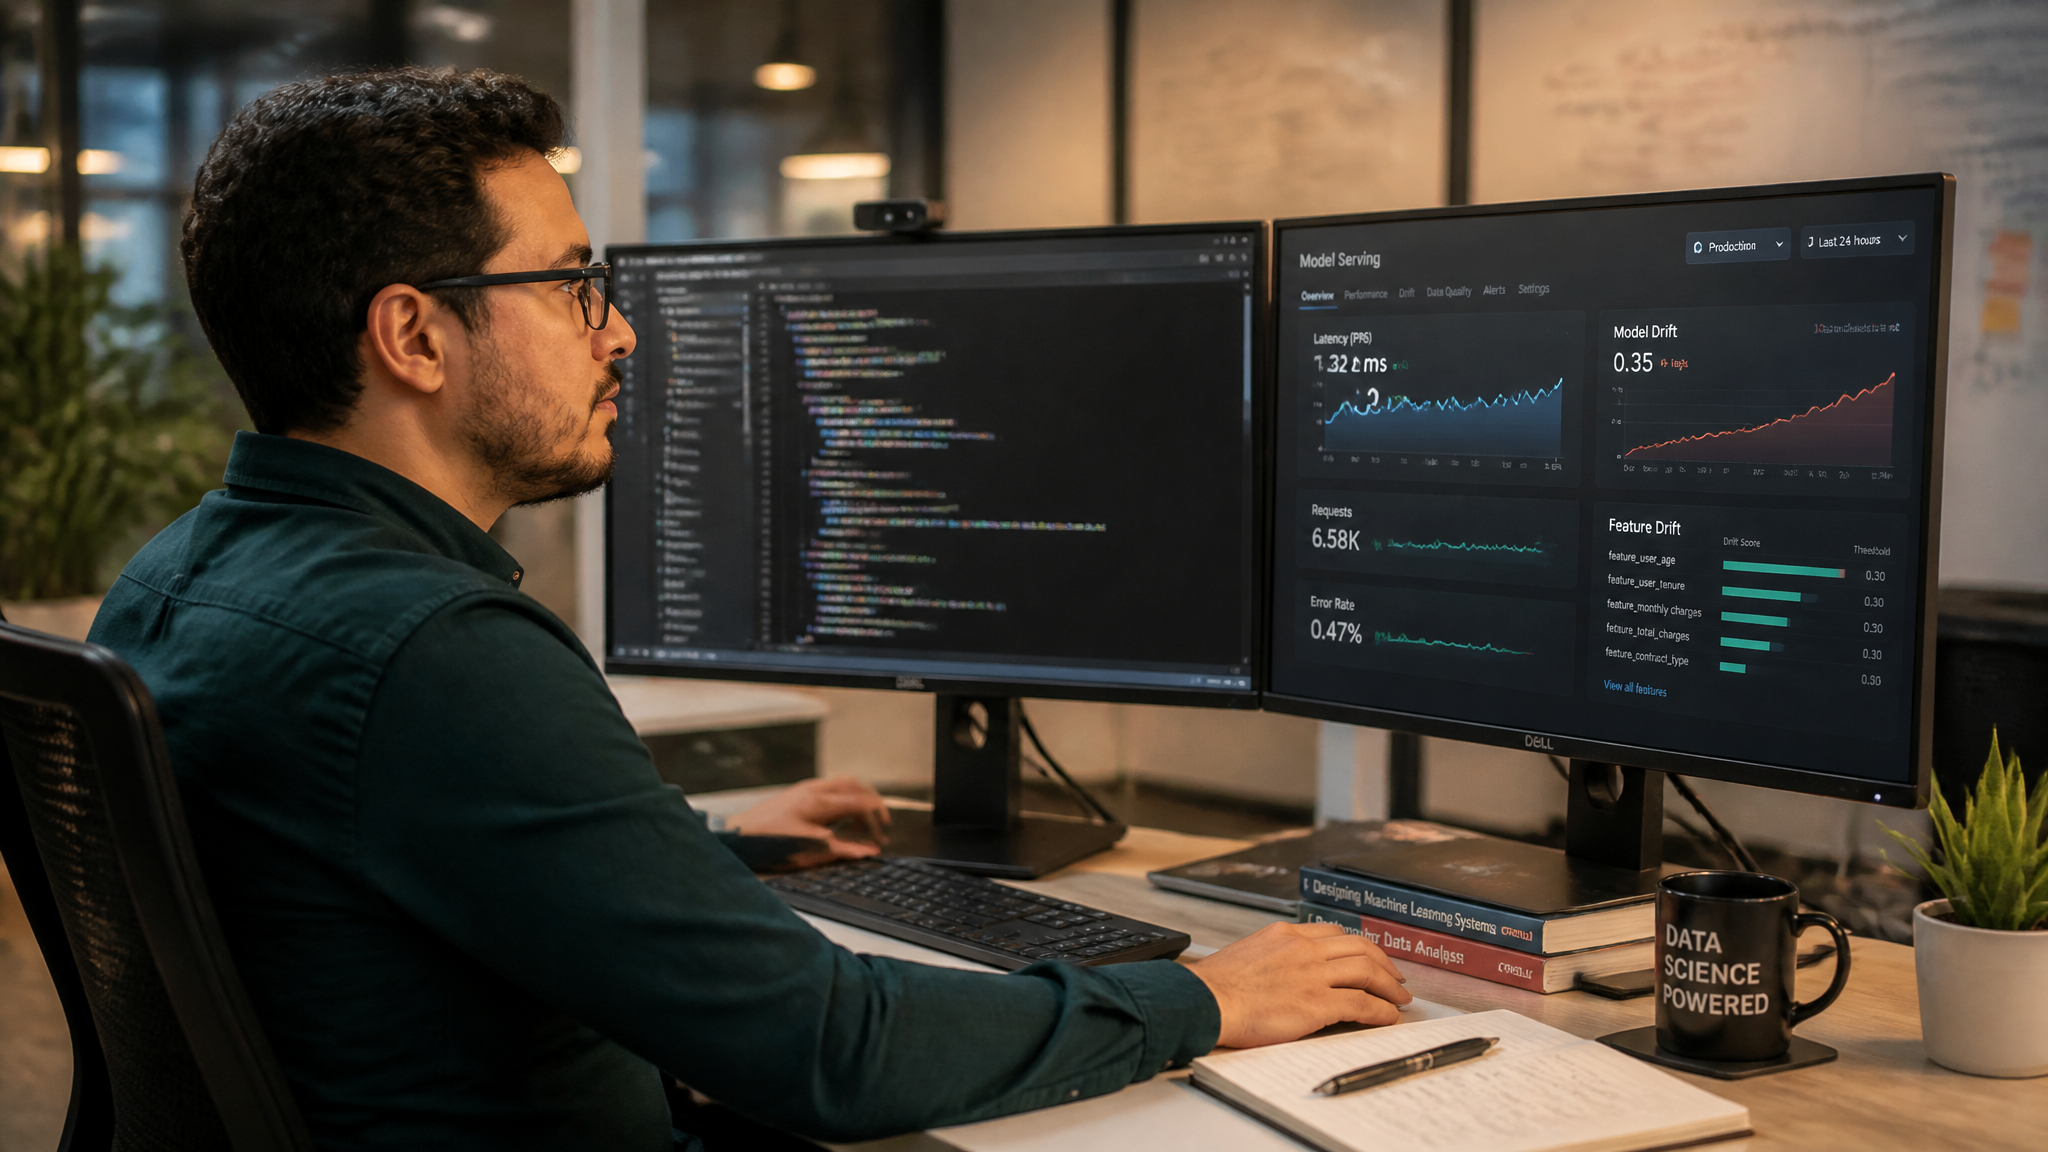
- Monitoreo continuo: recolección de métricas de infraestructura (latencia, errores) y de negocio (drift de datos, precisión en vivo).
- Reentrenamiento automatizado: pipelines que disparan un nuevo ciclo cuando las métricas cruzan umbrales predefinidos, incluyendo validación del nuevo modelo antes de reemplazar al anterior.
Este enfoque exige que el modelo sea solo una pieza más de un engranaje mayor. De hecho, muchas organizaciones estiman que el código de ML representa menos del 10% del sistema total; el resto es infraestructura, gestión de datos y monitoreo.
Herramientas que todo ML Engineer debe manejar
El ecosistema actual es amplio, pero hay un núcleo de herramientas que aparecen una y otra vez en las ofertas de empleo y en los casos de éxito:
- Python y su stack científico: scikit-learn, pandas, numpy, matplotlib. Saber ajustar un Random Forest no es suficiente; el MLE conoce los hiperparámetros relevantes, el impacto de las transformaciones de features y cómo hacer que un pipeline de scikit-learn se comporte de forma idéntica en entrenamiento y en inferencia.
- MLflow: para registrar experimentos, empaquetar modelos en formatos estándar y gestionar un modelo registry. Facilita la trazabilidad entre el experimento y el artefacto desplegado.
- Docker: empaquetar el modelo y sus dependencias en una imagen inmutable. Evita el clásico "en mi máquina funciona".
- Kubernetes: para orquestar contenedores, escalar réplicas y gestionar despliegues canary o blue-green.
- Plataformas cloud: AWS SageMaker, Google Vertex AI o Azure Machine Learning ofrecen servicios gestionados que simplifican el despliegue y el monitoreo, aunque siempre conviene entender qué ocurre bajo el capó.
- Orquestadores de pipelines: Apache Airflow, Prefect o Dagster permiten programar flujos de ingesta, entrenamiento y despliegue.
- Monitoreo: Prometheus y Grafana para métricas de sistema; soluciones como WhyLabs o NannyML para detectar drift en los datos de entrada.
La elección de herramientas depende del contexto. Un MLE senior sabe cuándo basta con un script de cron y cuándo es imprescindible Kubernetes, y evita sobreingeniería en etapas tempranas.
Preparación del modelo: más allá del accuracy
Un modelo puede tener un F1-score brillante y aun así fracasar en producción. Antes de desplegar, el MLE revisa varios frentes:
- Latencia y throughput: ¿cuánto tarda una predicción? Modelos basados en ensambles profundos de árboles o en redes neuronales pueden ser demasiado lentos para aplicaciones síncronas. A veces una regresión logística con features bien diseñadas supera en velocidad a un modelo más complejo sin sacrificar demasiada precisión.
- Tamaño del artefacto: un modelo serializado puede ocupar cientos de megabytes. Convertirlo a ONNX o a TensorFlow Lite reduce el footprint y acelera la carga en frío.
- Explicabilidad: en sectores regulados (finanzas, salud) no basta con predecir; hay que justificar la decisión. Técnicas como SHAP o LIME ayudan, pero integran complejidad en el pipeline de inferencia.
- Validación de entradas: el modelo debe rechazar datos fuera de rango o con tipos incorrectos sin romperse. Una envoltura con validación de esquemas (pydantic, marshmallow) es una capa de seguridad indispensable.
Además, todo modelo debe estar versionado, tanto el artefacto como el código que lo genera y los datos de entrenamiento. Herramientas como DVC (Data Version Control) vinculan datasets con commits de Git, cerrando el triángulo de reproducibilidad.
Estrategias de despliegue
No existe una sola forma de poner un modelo en producción. Las tres aproximaciones más comunes son:
- Inferencia por lotes (batch inference): se ejecuta periódicamente (cada hora, cada noche) sobre un conjunto de datos almacenado, y los resultados se escriben en una base de datos o en un almacén de objetos. Ideal para scores de riesgo crediticio o segmentación de clientes. Baja complejidad operativa, alta latencia global.
- API en tiempo real: el modelo se expone mediante un endpoint REST (Flask, FastAPI) o gRPC. La aplicación cliente envía una solicitud y recibe la predicción en milisegundos. Exige gestión de concurrencia, balanceo de carga y posiblemente autoescalado.
- Streaming: los datos de entrada fluyen por un sistema de mensajería (Apache Kafka, AWS Kinesis) y el modelo procesa cada mensaje a medida que llega. Arquitectura más compleja pero ideal para detección de fraude o mantenimiento predictivo en tiempo real.
El MLE elige la opción según los requisitos de latencia, el volumen de peticiones y la criticidad del servicio. Un error común es asumir que todo necesita una API síncrona cuando un proceso batch diario cubriría la necesidad del negocio con un coste diez veces menor.
Caso práctico: despliegue de un clasificador con scikit-learn y Flask
Vamos a tierra. Supongamos que ha entrenado un clasificador de flores (el dataset Iris) usando un Random Forest. El modelo está listo en su notebook. Ahora lo llevaremos a un entorno productivo mínimo pero realista.
1. Serializar el modelo entrenado
import joblib
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier

iris = load_iris()
X, y = iris.data, iris.target
model = RandomForestClassifier(n_estimators=50, random_state=42)
model.fit(X, y)
joblib.dump(model, 'model.joblib')
print('Modelo guardado.')
El archivo model.joblib contiene todo lo necesario para hacer predicciones sin reentrenar.
2. Crear una API con Flask
from flask import Flask, request, jsonify
import joblib
import numpy as np

app = Flask(__name__)
model = joblib.load('model.joblib')

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json(force=True)
    features = np.array(data['features'])
    prediction = model.predict(features).tolist()
    return jsonify({'prediction': prediction})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
El endpoint /predict espera un JSON con la clave features y devuelve la clase predicha. Este código asume que las entradas están validadas. Para producción, añadiríamos validación con pydantic y manejo de errores.
3. Probar el servicio localmente
Ejecute python app.py y desde otra terminal lance una petición con curl:
curl -X POST http://localhost:5000/predict \
  -H 'Content-Type: application/json' \
  -d '{"features": [[5.1, 3.5, 1.4, 0.2]]}'
Debería recibir una respuesta con la predicción.
4. Contenerizar con Docker
Cree un Dockerfile mínimo:
FROM python:3.10-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY model.joblib app.py ./
EXPOSE 5000
CMD ['python', 'app.py']
Genere la imagen y ejecute el contenedor:
docker build -t iris-classifier .
docker run -p 5000:5000 iris-classifier
Ahora el modelo corre aislado de su entorno local. Cualquier máquina con Docker puede levantarlo.
5. Despliegue en una VM cloud
Puede llevar la imagen a un registro (Docker Hub, ECR) y ejecutarla en una instancia EC2, una VM de GCP o un servicio gestionado como Cloud Run. Con unos pocos comandos, el modelo estará sirviendo predicciones a través de una IP pública. Añadir un balanceador de carga y HTTPS completa la puesta en producción.
Este flujo es la base sobre la que se construyen sistemas más complejos. A medida que el tráfico crece, Kubernetes y los pipelines de integración continua se vuelven necesarios, pero los fundamentos permanecen.
Monitoreo y mantenimiento: el trabajo nunca termina
Desplegar es solo el primer día del resto de la vida del modelo. En producción, el mundo cambia y el modelo se degrada silenciosamente. El MLE implementa tres pilares de observabilidad:
- Métricas de infraestructura: uso de CPU, memoria, latencia de las peticiones y tasa de errores. Un pico de latencia puede indicar que el modelo es demasiado pesado o que la carga es mayor de la esperada.
- Drift de datos: las distribuciones de las features de entrada pueden alejarse de las del conjunto de entrenamiento. El drift se detecta comparando estadísticas (media, desviación, histogramas) entre la ventana actual y la de referencia. Herramientas como Evidently AI o Alibi Detect facilitan este análisis.
- Rendimiento del modelo en vivo: idealmente se contrastan las predicciones con los resultados reales cuando estos se conocen (por ejemplo, si un cliente aceptó una oferta). Si no hay ground truth inmediato, se pueden usar métricas proxy.
Configurar alertas tempranas y pipelines de reentrenamiento condicional evita que los usuarios detecten el problema antes que el equipo de ingeniería. Un modelo que lleva seis meses sin actualizarse es una bomba de tiempo.
Errores típicos al poner modelos en producción
Incluso equipos con experiencia caen en patrones que convierten un buen proyecto en un fracaso operativo. Los más frecuentes:
- Saltar de Jupyter a Kubernetes sin etapas intermedias: probar primero con una API local, luego un contenedor en una VM, y solo añadir orquestación cuando la carga lo justifique. La complejidad prematura mata proyectos.
- Ignorar la validación de datos de entrada: un valor nulo donde no se esperaba puede tumbar el servicio si el modelo no está preparado. Defina esquemas estrictos y rechace peticiones mal formadas con mensajes claros.
- No versionar el modelo ni los datos: sin trazabilidad, es imposible depurar un error o replicar un resultado. Use herramientas como MLflow y DVC desde el primer experimento que aspire a producción.
- Olvidar el coste de infraestructura: una GPU encendida 24/7 para un modelo que recibe cinco peticiones al día es un despilfarro. Evalúe opciones serverless (AWS Lambda, Cloud Run) para cargas bajas.
- No diseñar para el fallo: incluya reintentos, circuit breaker y un plan de rollback. El endpoint del modelo debe degradarse con gracia, devolviendo una predicción por defecto o un mensaje de indisponibilidad temporal.
Evitar estos tropiezos ahorra dinero y, sobre todo, credibilidad ante el negocio. El MLE no es quien entrena el modelo más exótico, sino quien garantiza que las predicciones sean confiables y estén disponibles cuando se necesitan.
El dominio de estas prácticas convierte a un profesional en un perfil altamente demandado. Con cada vez más empresas buscando extraer valor de sus datos, la capacidad de cerrar el ciclo completo, desde el dato hasta la decisión automatizada, es la habilidad que marca la diferencia en el mercado actual.