Ingeniero de Visión por Computadora: Guía Completa de Carrera y Competencias en 2025
Domina la visión por computadora y construye sistemas de detección de objetos desde cero.
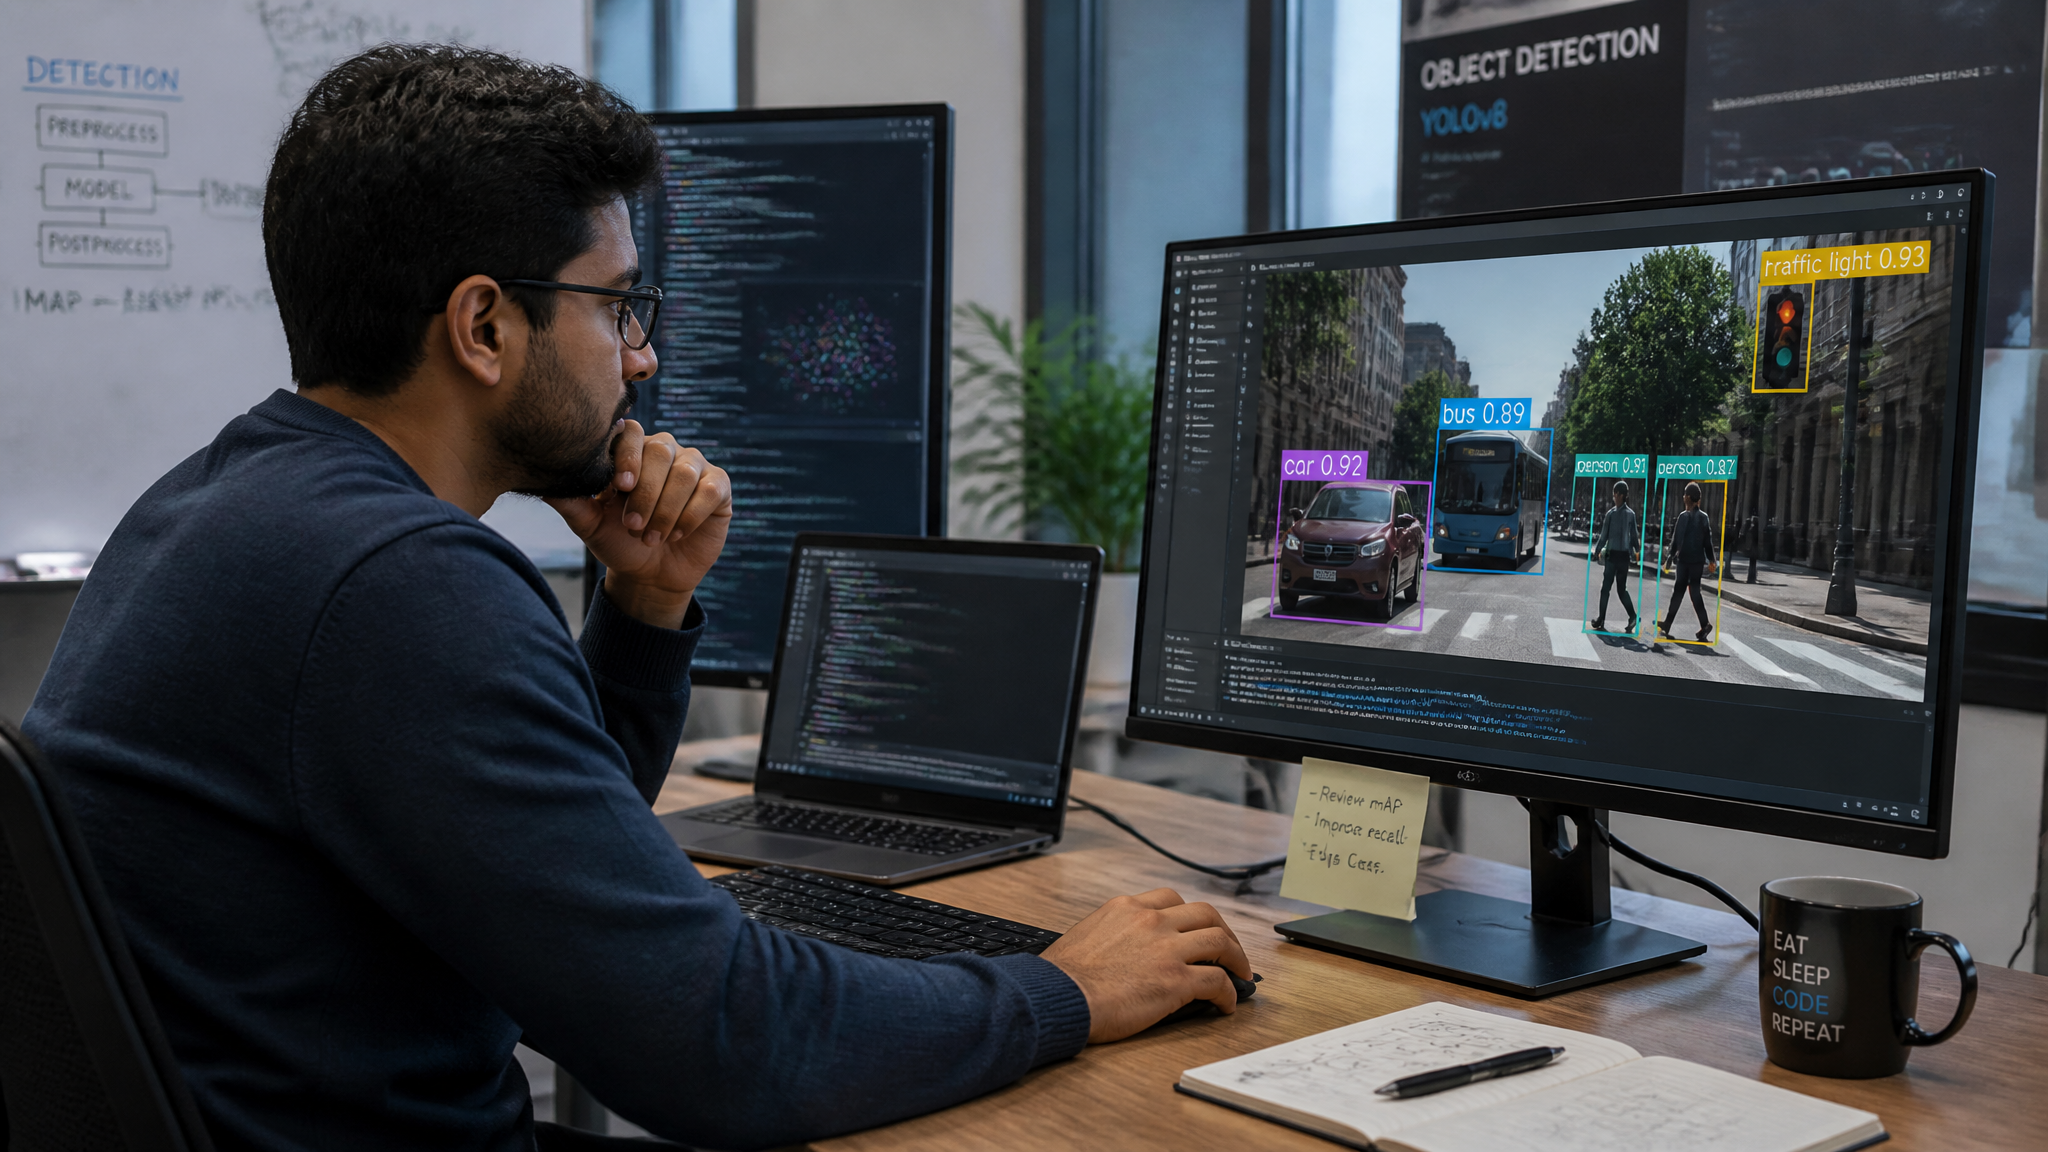
Por Jose Luis Rueda · 10 min lectura · 2026-07-12
La inteligencia artificial ya no es un lujo, es una necesidad competitiva. Dentro de este ecosistema, el Computer Vision Engineer se ha convertido en el perfil más demandado por empresas que buscan automatizar la inspección visual, entender el comportamiento de clientes o crear productos autónomos. Este artículo te ofrece una ruta práctica para dominar la visión por computadora, desde los fundamentos hasta la construcción de tu primer detector de objetos.
Trabajar con imágenes y vídeo requiere una mezcla única de matemáticas, programación y conocimiento del problema de negocio. Aquí desglosamos las herramientas, los algoritmos y la metodología que necesitas para dar el salto. Incluye un minicapítulo dedicado a cómo estructurar un proyecto real, inspirado en la experiencia de ingenieros que han usado prompts especializados, como los que ofrece HolaGPT, para acelerar su flujo de trabajo.
1. ¿Qué hace un Computer Vision Engineer?
Un ingeniero de visión por computadora diseña, implementa y optimiza sistemas que extraen información de imágenes o secuencias de video. Su trabajo abarca desde la detección de defectos en una línea de producción hasta el reconocimiento facial en dispositivos móviles. A diferencia de un científico de datos tradicional, este perfil domina el procesamiento de señales, la geometría de múltiples vistas, el calibrado de cámaras y, cada vez más, las redes neuronales profundas.
Las tareas diarias incluyen recolectar datasets, anotar imágenes, entrenar modelos como YOLO o Mask R-CNN, evaluar métricas (mAP, IoU) y desplegar el sistema en edge devices o en la nube. La comunicación con equipos de producto es clave para traducir una necesidad vaga en un problema de visión bien definido.
2. Habilidades técnicas imprescindibles
Programación y matemáticas
Python es el lenguaje rey. Necesitas fluidez en NumPy, Pandas y scikit-image. Las matemáticas son el esqueleto: álgebra lineal, cálculo diferencial y probabilidad. Conceptos como convolución, transformada de Fourier o descenso de gradiente deben ser tan familiares como un bucle for.
Frameworks de deep learning
PyTorch domina la investigación y TensorFlow la producción. Aprender Keras y ONNX te dará portabilidad. No olvides las herramientas de visualización como TensorBoard o Wandb para monitorizar entrenamientos.
3. Herramientas esenciales
OpenCV: el estándar industrial
OpenCV es la navaja suiza del computer vision. Con más de 2500 algoritmos optimizados, permite desde leer un frame de cámara hasta aplicar filtros de Canny o extraer contornos. Su integración con C++ y Python la hace imbatible en sistemas embebidos.
TensorFlow y PyTorch
TensorFlow ofrece un ecosistema robusto para producción con TF Serving y TF Lite. PyTorch, gracias a su grafo dinámico, acelera la experimentación. Ambos soportan la suite de modelos preentrenados de Hugging Face, que ahorra semanas de desarrollo.
YOLO, Detectron2 y más
Para detección de objetos, no necesitas reinventar la rueda. YOLOv8 ofrece detección en tiempo real con una sola red. Detectron2, de Meta, implementa Faster R-CNN y Mask R-CNN. Ultralytics ha llevado YOLO a un ecosistema amigable. Con estos modelos preentrenados puedes afinar sobre tus propios datos en horas.
4. Algoritmos de detección de objetos más usados
Redes convolucionales (CNN)
Las CNN aprenden jerarquías de características. En detección, se usan como backbone: desde VGG16 hasta EfficientNet o Swin Transformers. La clave es elegir un backbone que equilibre precisión y velocidad.
Modelos de una sola etapa vs dos etapas
Los detectores de una etapa (YOLO, SSD) predicen cajas y clases directamente sobre el mapa de features. Son rápidos pero menos precisos en objetos pequeños. Los de dos etapas (Faster R-CNN) generan propuestas de región y luego clasifican. Rinden mejor en detalle fino. La elección depende del caso de uso: una cámara de seguridad en tiempo real preferirá YOLO, un sistema de diagnóstico médico exigirá más precisión.
5. Cómo construir un sistema de detección de objetos paso a paso
Siguiendo la filosofía de proyectos reales, vamos a detallar cada fase. Esta metodología es la misma que utilizarías al trabajar con un prompt de IA como los disponibles en HolaGPT para desarrollar sistemas desde cero.
1. Definición del problema: decide qué objetos detectar, el entorno (iluminación, ángulos) y las restricciones de hardware.
2. Recolección y anotación de datos: mínimo miles de imágenes por clase. Herramientas como LabelImg, CVAT o Roboflow. La calidad de las anotaciones determina el 80% del éxito.
3. Preprocesamiento: redimensionado, normalización, aumento de datos (flips, rotaciones, cambios de color) para mejorar la generalización.
4. Elección del modelo: si necesitas velocidad, YOLOv8-Nano; si precisión, YOLOv8-X o Faster R-CNN con ResNet50.
5. Entrenamiento: divide en train/val/test. Monitoriza la pérdida y métricas como [email protected]. Usa early stopping y guarda los mejores pesos.
6. Evaluación: matriz de confusión, curvas PR, análisis de falsos positivos. Itera sobre el dataset si hay clases desbalanceadas.
7. Despliegue: convierte el modelo a TensorRT o ONNX para optimización en producción. Puedes embeberlo en una aplicación con Flask o integrarlo en un pipeline con Kafka.
Cada paso puede refinarse con prompts iterativos. Por ejemplo, puedes pedir a una IA: 'Actúa como un experto en OpenCV y sugiere una mejora para reducir falsos positivos en condiciones de baja luz'. Plataformas como HolaGPT ofrecen un entorno optimizado para profesionales hispanos que quieren acelerar la resolución de problemas específicos sin perder el control técnico.
6. Salidas profesionales y salario en Latinoamérica y USA
La demanda explota. Según LinkedIn, los puestos de Computer Vision crecen un 35% anual. En Estados Unidos, un CV engineer junior puede ganar $90k-$120k anuales, y seniors superan los $180k. En Latinoamérica, los sueldos oscilan entre $2.500 y $5.500 mensuales para perfiles con experiencia, trabajando remoto para empresas extranjeras. Las industrias más activas: automotriz (autonomous driving), retail (inventario automatizado), salud (radiología asistida) y seguridad (videovigilancia inteligente).
7. Preguntas frecuentes (FAQ)
¿Necesito un doctorado para trabajar en visión por computadora?
No es imprescindible. Un grado en informática, matemáticas o ingeniería con un portfolio sólido es suficiente. La experiencia práctica y proyectos en GitHub pesan más que el título.
¿Cuál es el mejor lenguaje para computer vision?
Python por su ecosistema. C++ para optimización en tiempo real. Ambos se complementan.
¿Cuánto tiempo lleva dominar OpenCV?
Con dedicación diaria, en 3 meses puedes construir proyectos útiles. La maestría requiere uno o dos años resolviendo problemas reales.
¿Puedo usar solo OpenCV para detección de objetos moderna?
OpenCV incluye modelos preentrenados (DNN) pero para estado del arte necesitas YOLO o Detectron2. OpenCV te sirve para pre/postprocesamiento y despliegue.
¿Qué diferencia hay entre visión artificial y computer vision?
Son sinónimos. En la industria se usa más el término inglés.