Optimización de Clústeres Hadoop: Guía para Administradores
Estrategias prácticas para exprimir cada nodo de tu infraestructura de big data
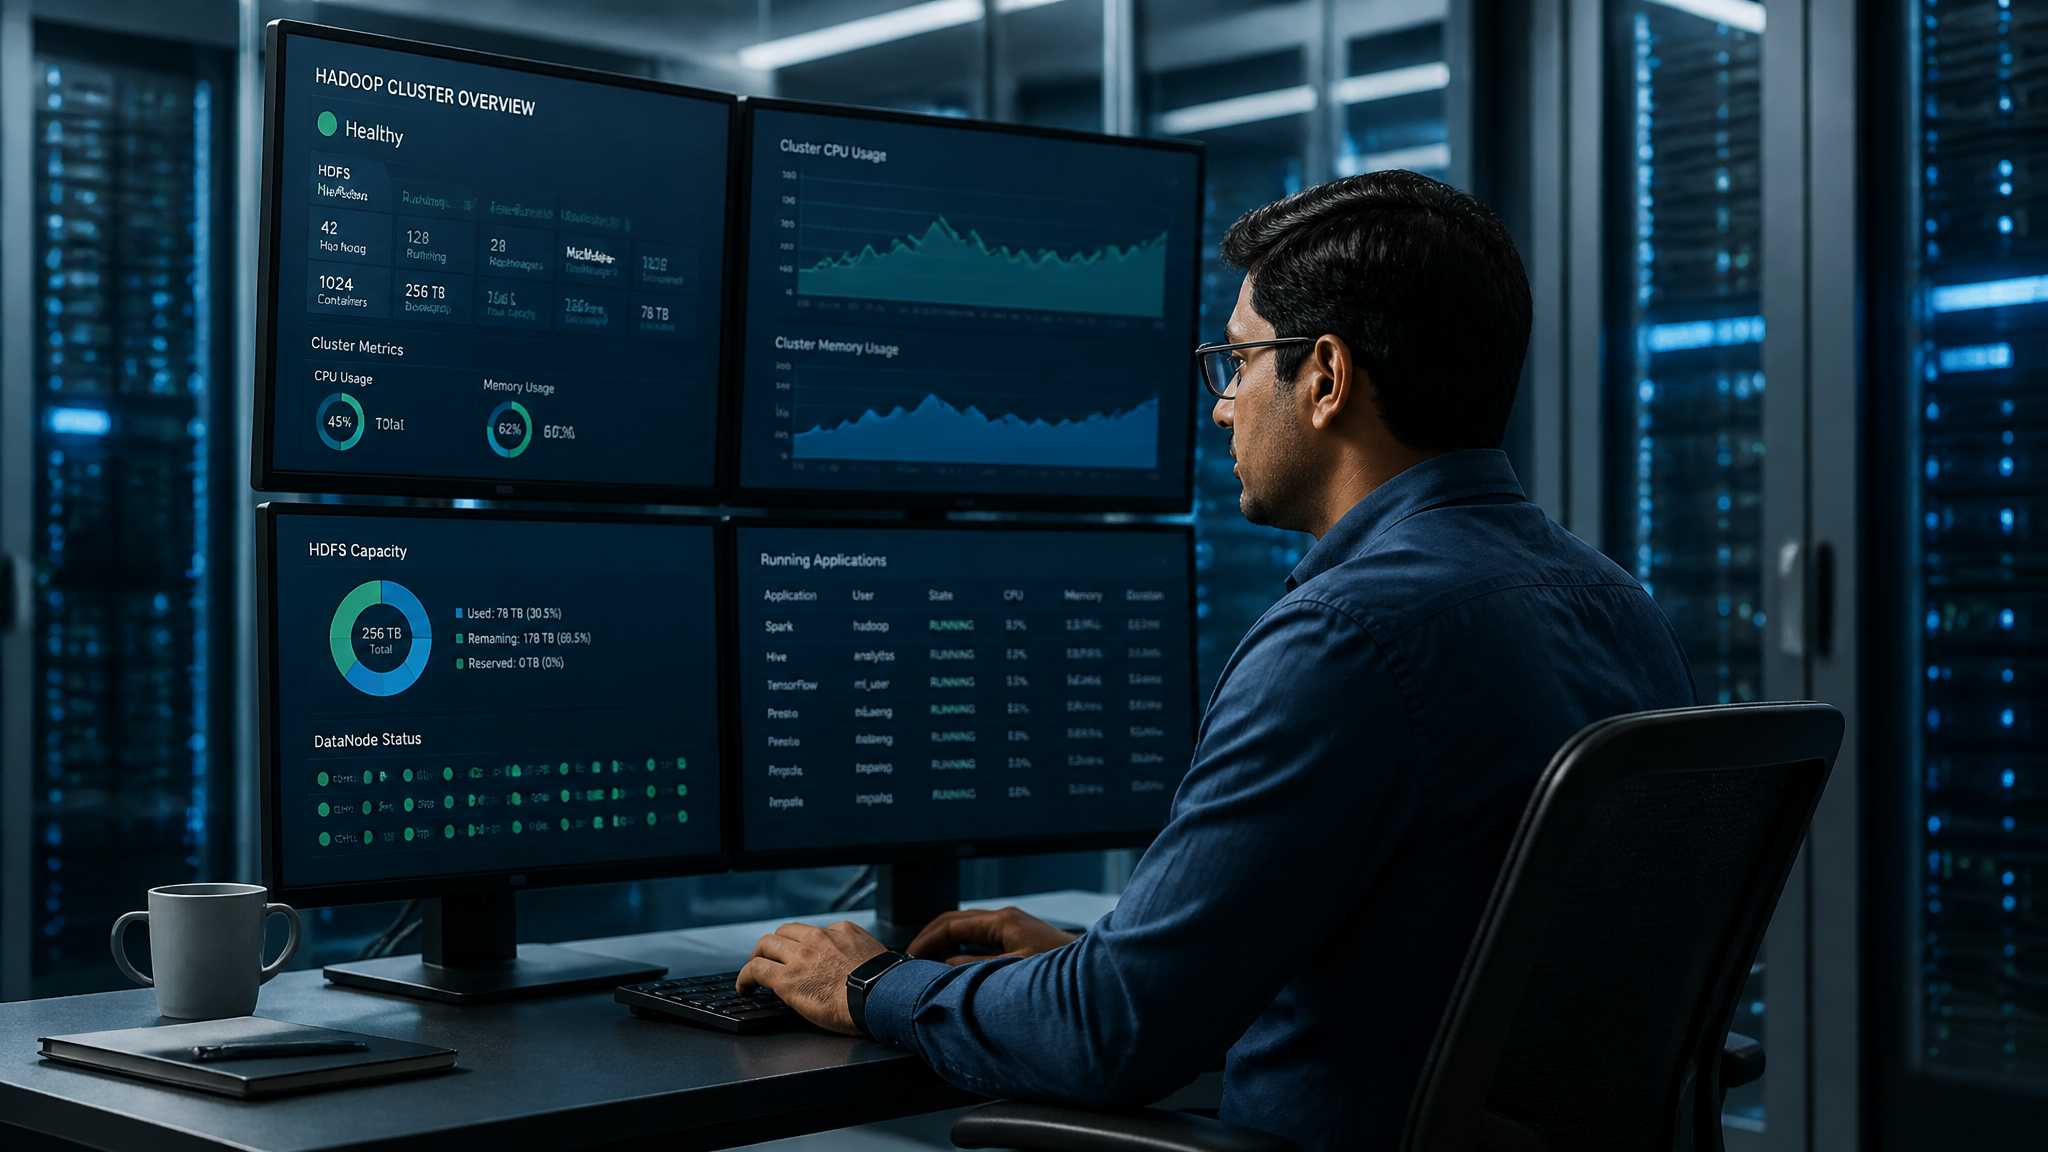
Por Jose Luis Rueda · 12 min lectura · 2026-07-24
La administración de clústeres Hadoop no es tarea sencilla. Cada nodo, cada trabajo MapReduce y cada byte en HDFS exigen una supervisión constante. Los profesionales de datos saben que un clúster mal afinado consume recursos, ralentiza consultas y genera costes innecesarios. Este artículo desgrana las técnicas que utilizan los administradores experimentados para mantener sus entornos en forma.
Apache Hadoop, con su ecosistema de herramientas, permite procesar petabytes de información. Sin embargo, la configuración por defecto rara vez funciona en producción. Ajustar parámetros de memoria, replicación y planificación de tareas marca la diferencia entre un sistema que responde en segundos y uno que se arrastra. Aquí aprenderás a diagnosticar problemas, aplicar soluciones y automatizar procesos con ayuda de herramientas como HolaGPT.
Tanto si gestionas un clúster on‑premise de 50 nodos como si trabajas con distribuciones cloud, los principios de optimización son similares. Sigue leyendo para dominar el arte de exprimir Hadoop.
Fundamentos de la Administración Hadoop
Un administrador de Hadoop no solo instala paquetes. Debe entender la anatomía del sistema: NameNode, DataNodes, ResourceManager, NodeManagers y el sistema de ficheros HDFS. El NameNode guarda los metadatos; si falla sin alta disponibilidad, el clúster se detiene. Por eso, la tolerancia a fallos comienza con un NameNode redundante y almacenamiento compartido en NFS o Quorum Journal.
Los DataNodes almacenan los bloques de datos. Por defecto, cada bloque tiene tres réplicas, pero en entornos de desarrollo se puede reducir a dos para ahorrar espacio. La configuración se define en hdfs-site.xml con dfs.replication. Mantener un equilibrio de réplicas evita sobrecargar nodos concretos. El comando hdfs balancer redistribuye bloques automáticamente; programarlo semanalmente es una buena práctica.
El ResourceManager (RM) de YARN asigna recursos a las aplicaciones. Los NodeManagers ejecutan los contenedores. Una configuración inadecuada de la memoria disponible en cada nodo provoca que las aplicaciones se queden sin recursos o que el sistema reserve demasiada RAM, limitando la capacidad de procesamiento. Cada administrador debe conocer los parámetros yarn.nodemanager.resource.memory-mb y yarn.scheduler.maximum-allocation-mb para definir los límites correctos.
Diagnóstico: Cómo Identificar Cuellos de Botella
Antes de modificar cualquier parámetro, hay que medir. La interfaz web del ResourceManager (puerto 8088 por defecto) muestra aplicaciones en ejecución, uso de recursos y colas. Si observas aplicaciones en estado ACCEPTED durante largos periodos, el clúster no tiene capacidad suficiente. La página de NodeManagers lista contenedores activos y su consumo de memoria. Un vistazo rápido indica si algún nodo está sobrecargado.
El comando yarn application -list -appStates ALL enumera todas las aplicaciones. Para investigar un trabajo concreto, yarn application -status detalla el tiempo de ejecución y los recursos asignados. En el lado de HDFS, hdfs dfsadmin -report ofrece un resumen del estado del sistema de ficheros: bloques corruptos, nodos en mantenimiento y espacio disponible. Presta especial atención a los bloques con réplicas por debajo del factor establecido, síntoma de nodos inestables.
Otra fuente de lentitud es el disco. Usa iostat en los DataNodes para comprobar latencias de escritura. Si el promedio de espera supera los 10 ms, el almacenamiento es un cuello de botella. La red también influye: iperf entre nodos mide el ancho de banda real. Hadoop funciona mejor con al menos 10 Gbps en entornos de producción. Por último, revisa los logs de los servicios con herramientas como journalctl o las bitácoras propias de Hadoop en $HADOOP_LOG_DIR.
Optimización de HDFS: Almacenamiento y Replicación
HDFS es la columna vertebral. Ajustar el tamaño de bloque no es un capricho: bloques más grandes (256 MB en lugar de 128 MB) reducen la sobrecarga de metadatos y mejoran el rendimiento en lecturas secuenciales. Cambia dfs.blocksize según el tipo de datos. Para ficheros pequeños, el verdadero problema es la proliferación de objetos en el NameNode. Usa hdfs dfs -getmerge o herramientas como Apache Parquet para consolidar información.
El comando hdfs fsck / -files -blocks -locations verifica la integridad del sistema. Si detectas bloques sub‑replicados, el clúster intentará replicarlos automáticamente, pero puede que necesites revisar la conectividad de los DataNodes afectados. Desactiva la replicación excesiva en trabajos temporales con dfs.replication=1 en la configuración de la aplicación.
Habilita la lectura de cortocircuito (short‑circuit local reads) para que los clientes lean directamente del disco sin pasar por el DataNode. Configura dfs.client.read.shortcircuit a true y define una ruta de socket en dfs.domain.socket.path. Esta mejora es especialmente notable en consultas interactivas con Hive o Spark. Además, activa la compresión nativa con códecs como Snappy, añadiendo las bibliotecas adecuadas y configurando io.compression.codecs.
Afinando YARN y MapReduce
YARN es el cerebro que reparte el trabajo. El parámetro yarn.nodemanager.resource.memory-mb debe reflejar la RAM disponible en el nodo menos el espacio reservado para el sistema operativo y otros procesos. Resta al menos 4 GB en servidores con 64 GB. Luego, define el tamaño mínimo y máximo de contenedor con yarn.scheduler.minimum-allocation-mb y yarn.scheduler.maximum-allocation-mb. Evita contenedores demasiado grandes que acaparan recursos.
En entornos con múltiples equipos, las colas de YARN son imprescindibles. Crea una cola capacity-scheduler.xml con capacidad mínima y máxima. Por ejemplo, asignar el 70% a producción y el 30% a desarrollo evita que un trabajo de pruebas bloquee las cargas críticas. El planificador también permite el adelantamiento de tareas (preemption) para recuperar recursos de contenedores inactivos.
MapReduce tiene sus propios ajustes. mapreduce.map.memory.mb y mapreduce.reduce.memory.mb controlan la memoria de cada fase. A menudo, el valor por defecto (1024 MB) es insuficiente para trabajos con grandes volúmenes de datos. Incrementa también mapreduce.task.io.sort.mb para absorber más datos en el buffer de ordenamiento. Si una tarea se ralentiza por esperas de E/S, aumenta el número de mapas concurrentes con mapreduce.job.running.map.limit.
Automatización Inteligente con HolaGPT
Los administradores repiten decenas de tareas: balancear discos, limpiar logs, generar informes de capacidad. Automatizar con scripts de Bash o Python ahorra horas de trabajo. Aquí es donde plataformas como HolaGPT entran en juego. Puedes describir en lenguaje natural qué necesitas, por ejemplo: “genera un script que recorra los DataNodes, obtenga la tasa de transferencia de disco y la compare con un umbral, enviando una alerta por correo”. La IA devuelve un script funcional adaptado a tu entorno.
Además, HolaGPT ayuda a crear fragmentos de configuración XML válidos. Si necesitas ajustar el capacity-scheduler.xml para añadir una cola con preemption, solo tienes que indicar las capacidades deseadas. Esta asistencia reduce los errores de sintaxis y acelera el despliegue en producción. Eso sí, siempre revisa el código antes de ejecutarlo; la IA es un copiloto, no un piloto automático.
Otro caso de uso es la generación de consultas YARN para monitoreo. Puedes pedir: “crea un script que obtenga el estado de las aplicaciones fallidas en las últimas 24 horas y las almacene en un archivo CSV”. HolaGPT responderá con un bloque preciso que combina yarn application -list y awk. Con el tiempo, construirás una biblioteca de asistentes que cubran el 80% de las tareas recurrentes.
Comandos Esenciales y Scripts de Monitoreo
Los comandos son el bisturí del administrador. Aquí tienes un arsenal que debes dominar:
hdfs dfsadmin -report: estado general del clúster.hdfs fsck /: comprobación de bloques.yarn application -list -appStates RUNNING: aplicaciones activas.yarn logs -applicationId: accede a los logs de una aplicación sin ir a la interfaz web.hadoop job -list: trabajos MapReduce en ejecución (modo clásico).hdfs balancer -threshold 5: reequilibra bloques con un umbral de desviación del 5%.
Para monitorización proactiva, combina estas herramientas con un script de recolección periódica. Por ejemplo, un Bash que ejecute hdfs dfsadmin -report cada hora, filtre la capacidad restante y envíe una alerta si baja del 10%. Utiliza cron para la programación y msmtp para el envío de correos. Los paneles con Grafana y Prometheus ofrecen una visualización más rica, pero los scripts simples son el primer paso.
No subestimes el comando du del sistema para inspeccionar los directorios de datos de los DataNodes. Un crecimiento inesperado de la carpeta dfs.datanode.data.dir puede indicar una fuga de bloques temporales. Programa una limpieza de archivos *.tmp con más de 7 días de antigüedad.
Casos Prácticos de Optimización
Caso 1: Clúster de 20 nodos con trabajos de Spark que tardan el doble de lo esperado.
Diagnóstico: la interfaz de YARN mostraba que el 90% de la memoria estaba asignada, pero la CPU no superaba el 30%. El problema era la fragmentación de contenedores. Solución: reducir yarn.scheduler.minimum-allocation-mb de 1024 a 512 MB y aumentar yarn.scheduler.maximum-allocation-mb a 32768 MB. Así se permitían contenedores más grandes sin desperdiciar pequeños huecos. El tiempo de ejecución se redujo un 45%.
Caso 2: Lecturas lentas en Hive sobre tablas externas.
Diagnóstico: iostat mostró picos de latencia de hasta 30 ms en discos HDD. Solución: migrar los datos calientes a nodos con SSD, habilitar short‑circuit local reads y añadir compresión Snappy. Las consultas pasaron de 12 segundos a 2,5 segundos.
Caso 3: NameNode en modo seguro con frecuencia.
El comando hdfs dfsadmin -safemode get indicaba que el sistema entraba en modo seguro por falta de réplicas. Se detectaron 3 DataNodes con conexión intermitente. Tras sustituir los cables de red defectuosos y aumentar el dfs.namenode.replication.work.multiplier.per.iteration a 4 para acelerar la re‑replicación, el problema desapareció.
Estos ejemplos demuestran que la optimización de Hadoop no es magia: es observación, ajustes finos y automatización. Mantén una bitácora de cambios para saber qué parámetros has modificado y por qué. En producción, nunca apliques más de un cambio a la vez; mide, compara y decide.