Análisis de Regresión: Guía Completa para Tomar Decisiones con Datos
De la teoría a la práctica: domina la técnica estadística que impulsa negocios inteligentes.
Por Jose Luis Rueda · 11 min lectura · 2026-08-02
Recibes un conjunto de datos y la pregunta inevitable aparece: ¿puedo hacer un análisis de regresión? La corta es sí, casi siempre se puede. La respuesta útil es otra: depende de qué quieras lograr y qué historia escondan tus datos. El análisis de regresión es una herramienta estadística que modela la relación entre una variable dependiente y una o más variables independientes. Se usa tanto para predecir valores futuros como para explicar por qué ocurren ciertos fenómenos.
En entornos profesionales, desde finanzas hasta marketing o logística, las regresiones permiten cuantificar el impacto de decisiones. Por ejemplo, cuánto aumentan las ventas por cada euro invertido en publicidad, o cómo influye la temperatura en el consumo energético de una planta. Esta guía recorre los fundamentos, los tipos de regresión más empleados, los requisitos que deben cumplir tus datos y un flujo de trabajo completo para implementar un modelo robusto, usando código real.
No necesitas un doctorado en estadística para sacar partido de estas técnicas. Con las herramientas actuales y un enfoque estructurado, profesionales y emprendedores pueden aplicar regresiones para respaldar sus decisiones con evidencia cuantitativa. Vamos paso a paso.
¿Qué es el Análisis de Regresión?
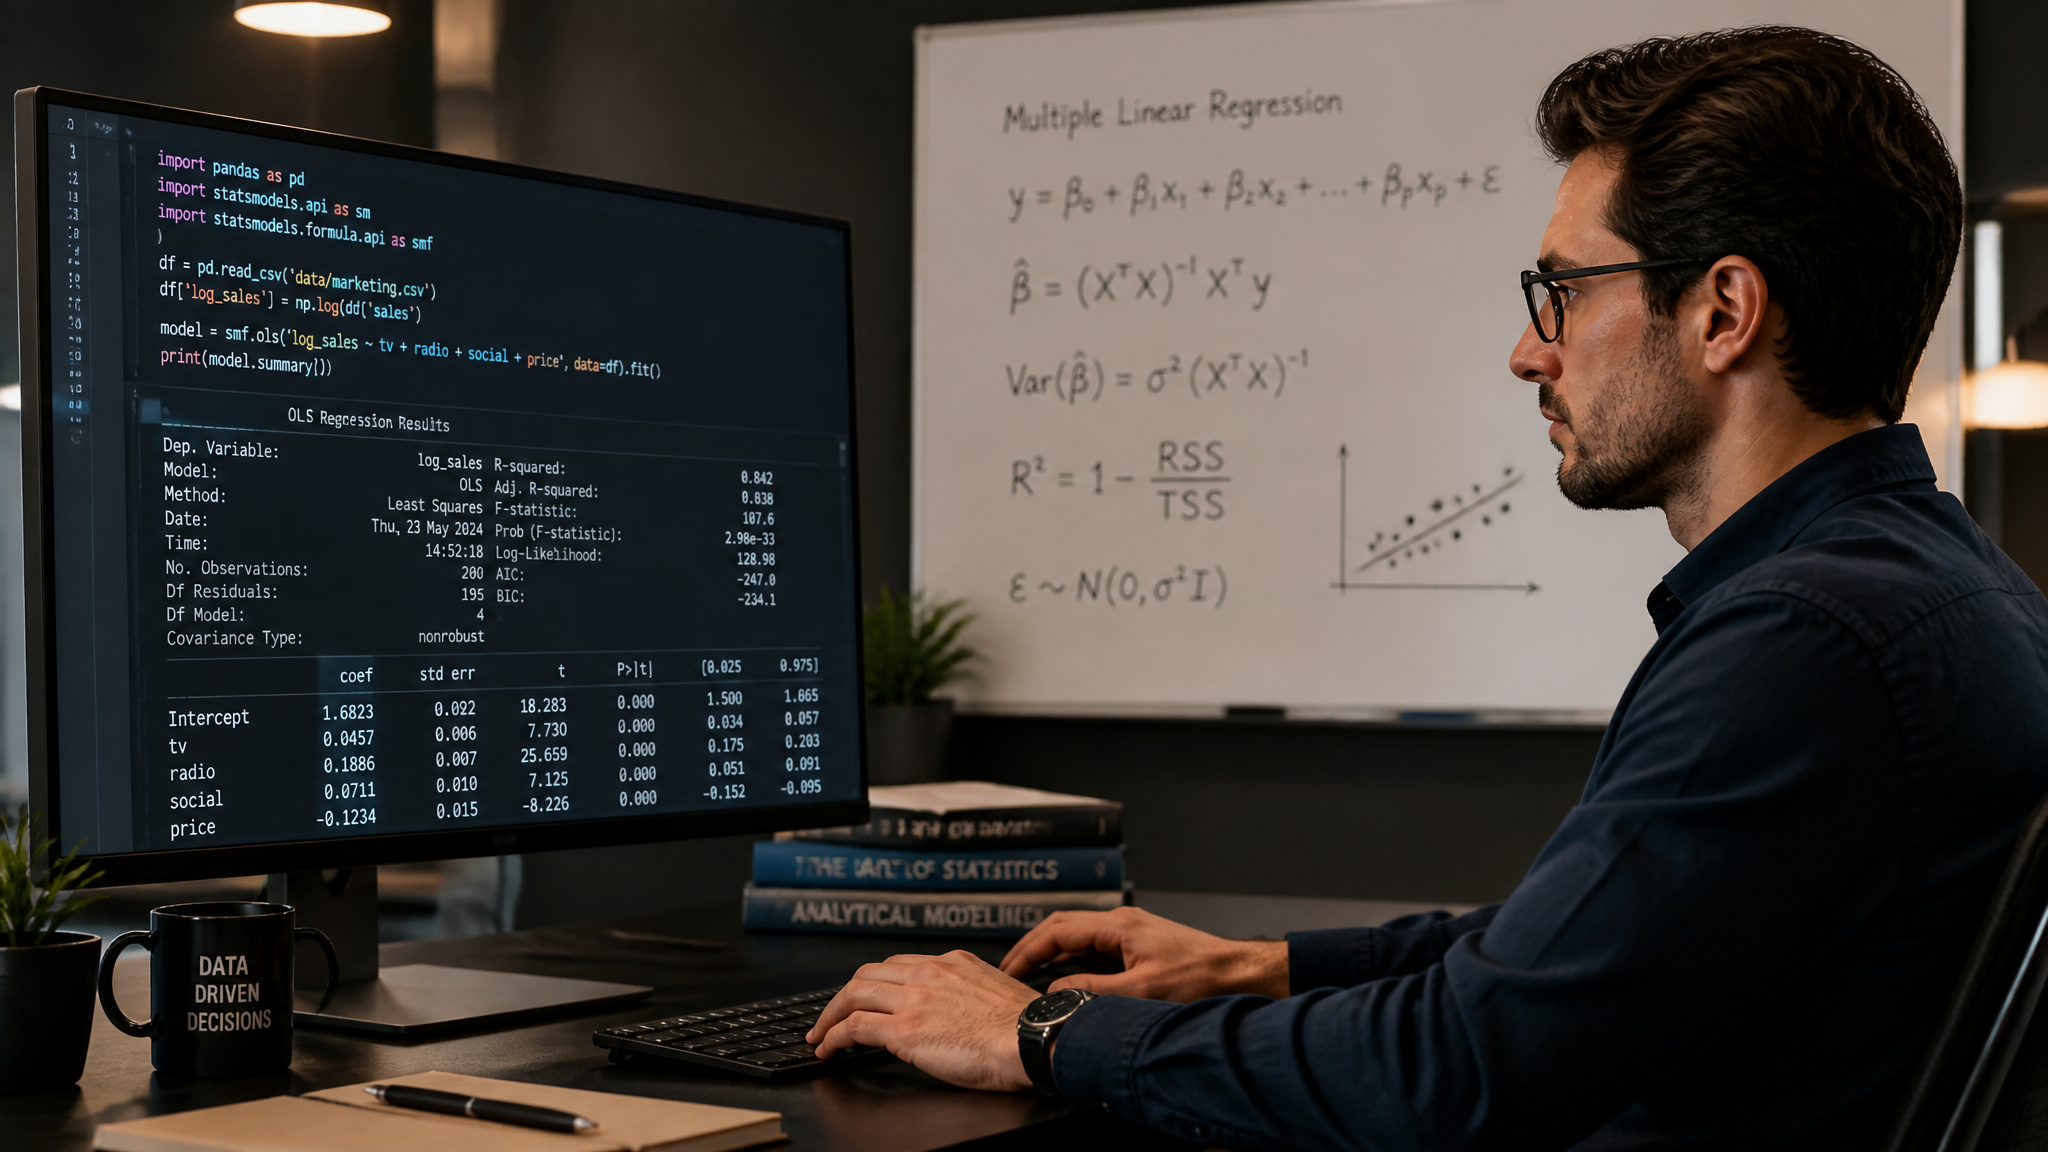
El análisis de regresión estima la relación matemática entre una variable que queremos explicar o predecir (variable dependiente, Y) y una o más variables predictoras (independientes, X). No se limita a decir "están relacionadas"; entrega una ecuación que permite cuantificar esa relación. La forma más simple es la regresión lineal: Y = a + bX + error. Aquí 'a' es la ordenada al origen, 'b' el coeficiente que indica cuánto cambia Y por cada unidad de X, y el error recoge lo que el modelo no explica.
Cuando tienes múltiples factores, la regresión lineal múltiple extiende la idea: Y = a + b1X1 + b2X2 + ... + bnXn. Esto permite aislar el efecto de cada variable manteniendo las demás constantes. Más allá de lo lineal, existen modelos para relaciones curvas, para clasificar categorías (regresión logística) o para datos con estructuras temporales complejas. El hilo conductor: todos buscan minimizar la diferencia entre lo que el modelo predice y los valores reales observados.
En la práctica, las empresas utilizan regresiones para tareas como estimar la demanda, fijar precios, evaluar campañas o detectar factores de riesgo. Un analista financiero puede modelar el rendimiento de una acción a partir de indicadores macroeconómicos; un director de operaciones, predecir tiempos de entrega según distancia y tráfico. La clave está en entender cuándo y cómo aplicar cada variante.
Tipos de Análisis de Regresión que Todo Profesional Debe Conocer
No existe un único modelo universal. La elección depende de la naturaleza de tu variable dependiente, la forma de la relación y los supuestos que puedas asumir. Aquí los más relevantes para el día a día profesional.
Regresión Lineal Simple y Múltiple
Es el punto de partida. Asume que la relación entre X e Y es aproximadamente una línea recta. La versión simple usa un solo predictor; la múltiple, varios. Es ideal cuando la variable de respuesta es continua (ventas, temperatura, costos) y las relaciones no muestran curvaturas evidentes. La interpretación es directa: cada coeficiente es el cambio esperado en Y por unidad de X, si todo lo demás permanece igual. Eso facilita la comunicación con equipos no técnicos.
Regresión Polinomial
Cuando un gráfico de dispersión revela una curva, una línea no basta. La regresión polinomial añade términos cuadráticos, cúbicos o de mayor grado: Y = a + b1X + b2X² + ... Sigue siendo un modelo lineal en los parámetros (los coeficientes se estiman con el mismo método de mínimos cuadrados), pero captura relaciones no lineales entre las variables. Útil en física, ingeniería o cuando modelas rendimientos decrecientes.
Regresión Logística
A pesar del nombre, es para clasificación binaria. La variable dependiente toma dos valores (compra/no compra, aprobado/rechazado, fuga de cliente sí/no). En lugar de predecir la clase directamente, estima la probabilidad de pertenecer a una categoría usando una función logística. El resultado se interpreta en términos de odds ratio: cuánto varía la probabilidad relativa al cambiar una variable independiente. Imprescindible en riesgo crediticio, medicina y marketing.
Regresión Ridge y Lasso
Cuando trabajas con muchas variables predictoras, la regresión múltiple puede sobreajustar o volverse inestable si hay correlaciones altas (multicolinealidad). Ridge y Lasso introducen un término de penalización que reduce los coeficientes hacia cero. Lasso, además, puede eliminar variables irrelevantes fijando coeficientes a cero, lo que lo convierte en una herramienta de selección automática de características. Ambos mejoran la capacidad predictiva en conjuntos de datos complejos.
Regresión para Series Temporales
Si tus datos tienen un orden cronológico y autocorrelación (el valor de hoy depende del de ayer), necesitas técnicas específicas. Modelos autorregresivos (AR), medias móviles (MA) o ARIMA modelan explícitamente la dependencia temporal. En entornos de negocio, se aplican para pronosticar ventas mensuales, inventarios o tráfico web.
¿Cuándo Puedes Realizar un Análisis de Regresión?
La pregunta inicial del prompt no es trivial. Realizar un análisis de regresión exige verificar ciertas condiciones. No se trata de lanzar datos a un software y aceptar el resultado sin más. Estas son las comprobaciones mínimas.
1. Naturaleza de las variables. La variable dependiente debe ser cuantitativa para regresión lineal, salvo que uses modelos generalizados (logística, Poisson). Las independientes pueden ser numéricas o categóricas codificadas. Si tu objetivo es clasificar, la familia de modelos cambia.
2. Linealidad de la relación. Para la regresión lineal, la relación entre cada X e Y debe ser razonablemente lineal en los parámetros. Esto no significa que las variables crudas deban estar en línea recta; puedes transformar X (logaritmo, raíz) o Y para linealizar. Gráficos de dispersión y residuos parciales ayudan a detectarlo.
3. Independencia de observaciones. Los datos de entrenamiento no deben estar correlacionados entre sí. Por ejemplo, mediciones repetidas del mismo sujeto o series temporales sin tratar violan este supuesto y requieren modelos específicos. Si tus datos provienen de un experimento bien aleatorizado, sueles cumplirlo.
4. Homocedasticidad (varianza constante de los errores). La dispersión de los residuos debe ser similar a lo largo de todos los valores predichos. Si la variabilidad aumenta con el valor ajustado (forma de embudo), tienes heterocedasticidad. Esto puede corregirse con transformaciones o usando errores estándar robustos.
5. Normalidad de los errores. Para inferencia estadística fiable (p-values, intervalos de confianza), los residuos deben seguir una distribución normal. Con muestras grandes, este supuesto es menos crítico gracias al teorema central del límite. Gráficos Q-Q y tests como Shapiro-Wilk permiten verificarlo.
6. Ausencia de multicolinealidad severa. Si dos o más variables independientes están altamente correlacionadas, los coeficientes se vuelven inestables y difíciles de interpretar. El factor de inflación de varianza (VIF) mide este problema: valores superiores a 5 o 10 suelen considerarse preocupantes.
7. Tamaño de muestra suficiente. No hay un número mágico. Una regla general es tener al menos 10-20 observaciones por cada variable predictora. Con pocos datos, el modelo puede memorizar ruido y no generalizar. Para regresión logística, se recomiendan al menos 10 eventos por predictor.
Si tu dataset no cumple alguno de estos puntos, no descartes la técnica. Existen alternativas: transformaciones, regularización, modelos robustos o simplemente adaptar la pregunta de negocio. La toma de decisiones con datos es un proceso iterativo.
Paso a Paso: Cómo Realizar un Análisis de Regresión desde Cero
Vamos con un flujo pragmático, desde los datos crudos hasta un modelo listo para usar. Lo ilustraremos con Python, el lenguaje más extendido en ciencia de datos, pero los conceptos aplican a R, Excel o cualquier herramienta que uses, HolaGPT puede ayudarte a generar y depurar el código necesario.
1. Exploración y Limpieza de Datos
Antes de modelar, entiende qué tienes. Calcula estadísticos descriptivos, visualiza distribuciones con histogramas y detecta valores faltantes o atípicos. Los datos perdidos puedes imputarlos con la mediana o usando modelos más sofisticados. Los outliers deben tratarse con cuidado: ¿son errores de medición o puntos de alto valor informativo? En regresión lineal, un atípico puede sesgar la recta. Técnicas como la distancia de Cook identifican observaciones influyentes.
import pandas as pd
import seaborn as sns

df = pd.read_csv('tus_datos.csv')
print(df.describe())
sns.pairplot(df)
df.isnull().sum()  # conteo de nulos
2. División en Entrenamiento y Prueba
Nunca evalúes el modelo con los mismos datos que usaste para construirlo. Separar una parte (típicamente 20-30%) permite estimar el rendimiento real en datos no vistos. Esto evita el sobreajuste y mide la capacidad de generalización.
from sklearn.model_selection import train_test_split

X = df.drop('target', axis=1)
y = df['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
3. Selección del Modelo y Entrenamiento
Comienza con un modelo sencillo como línea base. La regresión lineal múltiple con statsmodels ofrece una salida detallada para inferencia; sklearn es más eficiente para predicción y pipelines.
import statsmodels.api as sm

X_train_sm = sm.add_constant(X_train)  # agrega el intercepto
modelo = sm.OLS(y_train, X_train_sm).fit()
print(modelo.summary())
Esa tabla muestra coeficientes, p-values y R². Para un enfoque predictivo con sklearn:
from sklearn.linear_model import LinearRegression

reg = LinearRegression()
reg.fit(X_train, y_train)
y_pred = reg.predict(X_test)
4. Diagnóstico del Modelo
Un resumen numérico no basta. Analiza los residuos. Plotea residuos vs. valores ajustados para detectar patrones (heterocedasticidad o no linealidad no capturada). El gráfico Q-Q de los residuos evalúa normalidad. Si detectas problemas, itera: transforma variables, añade términos de interacción o cambia de modelo.
import matplotlib.pyplot as plt
residuos = y_test - y_pred
plt.scatter(y_pred, residuos)
plt.axhline(y=0, color='r', linestyle='--')
plt.xlabel('Predicciones')
plt.ylabel('Residuos')
5. Evaluación del Rendimiento
Para modelos de regresión, las métricas clave son el error cuadrático medio (MSE) y el coeficiente de determinación R². En datos de prueba, un R² de 0.80 significa que el modelo explica el 80% de la varianza. Ojo: R² siempre aumenta al añadir variables, por eso se usa el R² ajustado en inferencia. El error absoluto medio (MAE) es más interpretable en las unidades originales de Y.
from sklearn.metrics import mean_absolute_error, r2_score

print('MAE:', mean_absolute_error(y_test, y_pred))
print('R2:', r2_score(y_test, y_pred))
6. Interpretación y Comunicación
Traduce los números a decisiones. No digas solo "el coeficiente de marketing es 3.5". Di: "Por cada 1.000 euros adicionales invertidos en marketing, las ventas crecen en promedio 3.500 unidades, manteniendo constantes el precio y la estacionalidad". Ese lenguaje conecta con stakeholders. Y siempre acompaña los intervalos de confianza para reflejar la incertidumbre.
Errores Comunes que Sabotean un Análisis de Regresión
Incluso profesionales caen en trampas. Conocerlas te ahorra horas de frustración.
Confundir correlación con causalidad. Un modelo de regresión puede arrojar un coeficiente significativo incluso si no hay relación causal. Variables ocultas, causalidad inversa o pura coincidencia están detrás de muchas relaciones espurias. Por ejemplo, las ventas de helados y los ataques de tiburón se mueven juntos, pero no por una relación directa, sino porque ambos aumentan en verano. La regresión requiere diseño experimental o conocimiento de dominio para inferir causalidad.
Ignorar la multicolinealidad. Incluir variables como "gasto total en publicidad" y "gasto en anuncios de TV" puede disparar el VIF. Los coeficientes se vuelven erráticos y las pruebas de significancia pierden sentido. Antes de modelar, revisa la matriz de correlaciones y plantéate reducir dimensiones con PCA o selección manual.
Sobreajuste por exceso de variables. Meter 50 predictores para 100 observaciones es una receta para un modelo perfecto en entrenamiento pero inútil en producción. La regularización (Ridge, Lasso) o la selección stepwise ayudan, aunque esta última tiene críticas. Siempre valida en datos separados.
Extrapolación imprudente. Si tus datos de entrenamiento cubren precios entre 10 y 100, predecir ventas para un precio de 5 o 200 asume que la relación se mantiene fuera del rango observado, lo cual es peligroso. Los modelos aprenden patrones locales; no inventan leyes universales.
No estandarizar variables cuando corresponde. Para modelos que penalizan (Ridge, Lasso) o para comparar la importancia relativa de predictores en distintas escalas, es esencial estandarizar (restar media, dividir por desviación). De lo contrario, las variables con magnitudes grandes dominan artificialmente.
Casos de Uso Reales en Entornos Profesionales
Las regresiones no son un lujo académico. Aquí van situaciones concretas donde marcan la diferencia.
Retail: optimización de inventario. Una cadena de tiendas usa regresión lineal múltiple para predecir la demanda diaria de productos perecederos. Las variables: día de la semana, temperatura, proximidad de festivos y precio de la competencia. La reducción del desperdicio y las roturas de stock mejoró el margen un 12%.
RRHH: predicción de rotación. La regresión logística modela la probabilidad de que un empleado abandone la empresa en los próximos seis meses. Los predictores incluyen antigüedad, salario relativo al mercado, horas extra y distancia al trabajo. El área de talento activa planes de retención personalizados para los perfiles de alto riesgo.
Marketing: atribución de canales. Un ecommerce quiere saber el retorno real de cada canal. Mediante regresión con efectos fijos, aísla el impacto incremental de email, redes sociales y búsqueda pagada sobre el valor de compra, controlando por estacionalidad y características del cliente. Redistribuye el presupuesto hacia el canal más eficiente con evidencia estadística.
Finanzas: scoring crediticio. Bancos y fintechs entrenan modelos de regresión logística para estimar la probabilidad de impago. Variables como ingresos, historial de pagos y deuda actual se combinan para generar un puntaje. Una correcta calibración reduce la tasa de morosidad sin rechazar clientes solventes.
En todos estos ejemplos, el valor no está solo en la predicción, sino en entender qué palancas mueven el resultado. Eso permite actuar sobre las causas, no solo anticipar el desenlace.
Herramientas y Recursos para Implementar Regresiones Hoy
El ecosistema actual democratiza el acceso a estas técnicas. No dependes de un solo software. Python (con scikit-learn, statsmodels y pandas) y R son los estándares. Pero Excel ofrece complementos de análisis de datos para regresiones sencillas, y plataformas como Google Sheets se conectan a Apps Script o a APIs. Herramientas de IA como HolaGPT pueden asistirte en la escritura de código, la interpretación de salidas o la sugerencia de transformaciones cuando compartes capturas de tus gráficos de diagnóstico. Basta con describir el problema en lenguaje natural y la plataforma te devuelve un script funcional o una explicación detallada del output de statsmodels.
Si tu inclinación es visual, Tableau y Power BI integran opciones de línea de tendencia con bandas de confianza, aunque sus capacidades predictivas avanzadas requieren integración con Python o R. Lo importante es elegir la herramienta que se ajuste a tu flujo de trabajo y te permita compartir resultados de forma comprensible.
Reflexión Final: Más Allá del Modelo
El verdadero dominio del análisis de regresión no está en memorizar fórmulas, sino en desarrollar un pensamiento crítico sobre los datos. Pregúntate siempre: ¿estos datos representan el fenómeno que quiero modelar? ¿Qué sesgos pueden estar ocultos? ¿El modelo captura la complejidad necesaria sin ahogarse en ruido? Validar con expertos del dominio y con pruebas fuera de muestra convierte un ejercicio académico en una herramienta de negocio.
La próxima vez que enfrentes un dataset y te preguntes si puedes realizar un análisis de regresión, tendrás el marco para responder con confianza. Y si necesitas una mano para generar el código o interpretar un coeficiente que se resiste, recuerda que la IA, con plataformas como HolaGPT, puede ser tu analista junior siempre disponible, acelerando el camino desde los datos hasta la decisión informada.