Cómo Graficar un Histograma de Rendimientos Diarios con Python
Visualización práctica de datos financieros para traders y analistas
Por Jose Luis Rueda · 10 min lectura · 2026-07-31
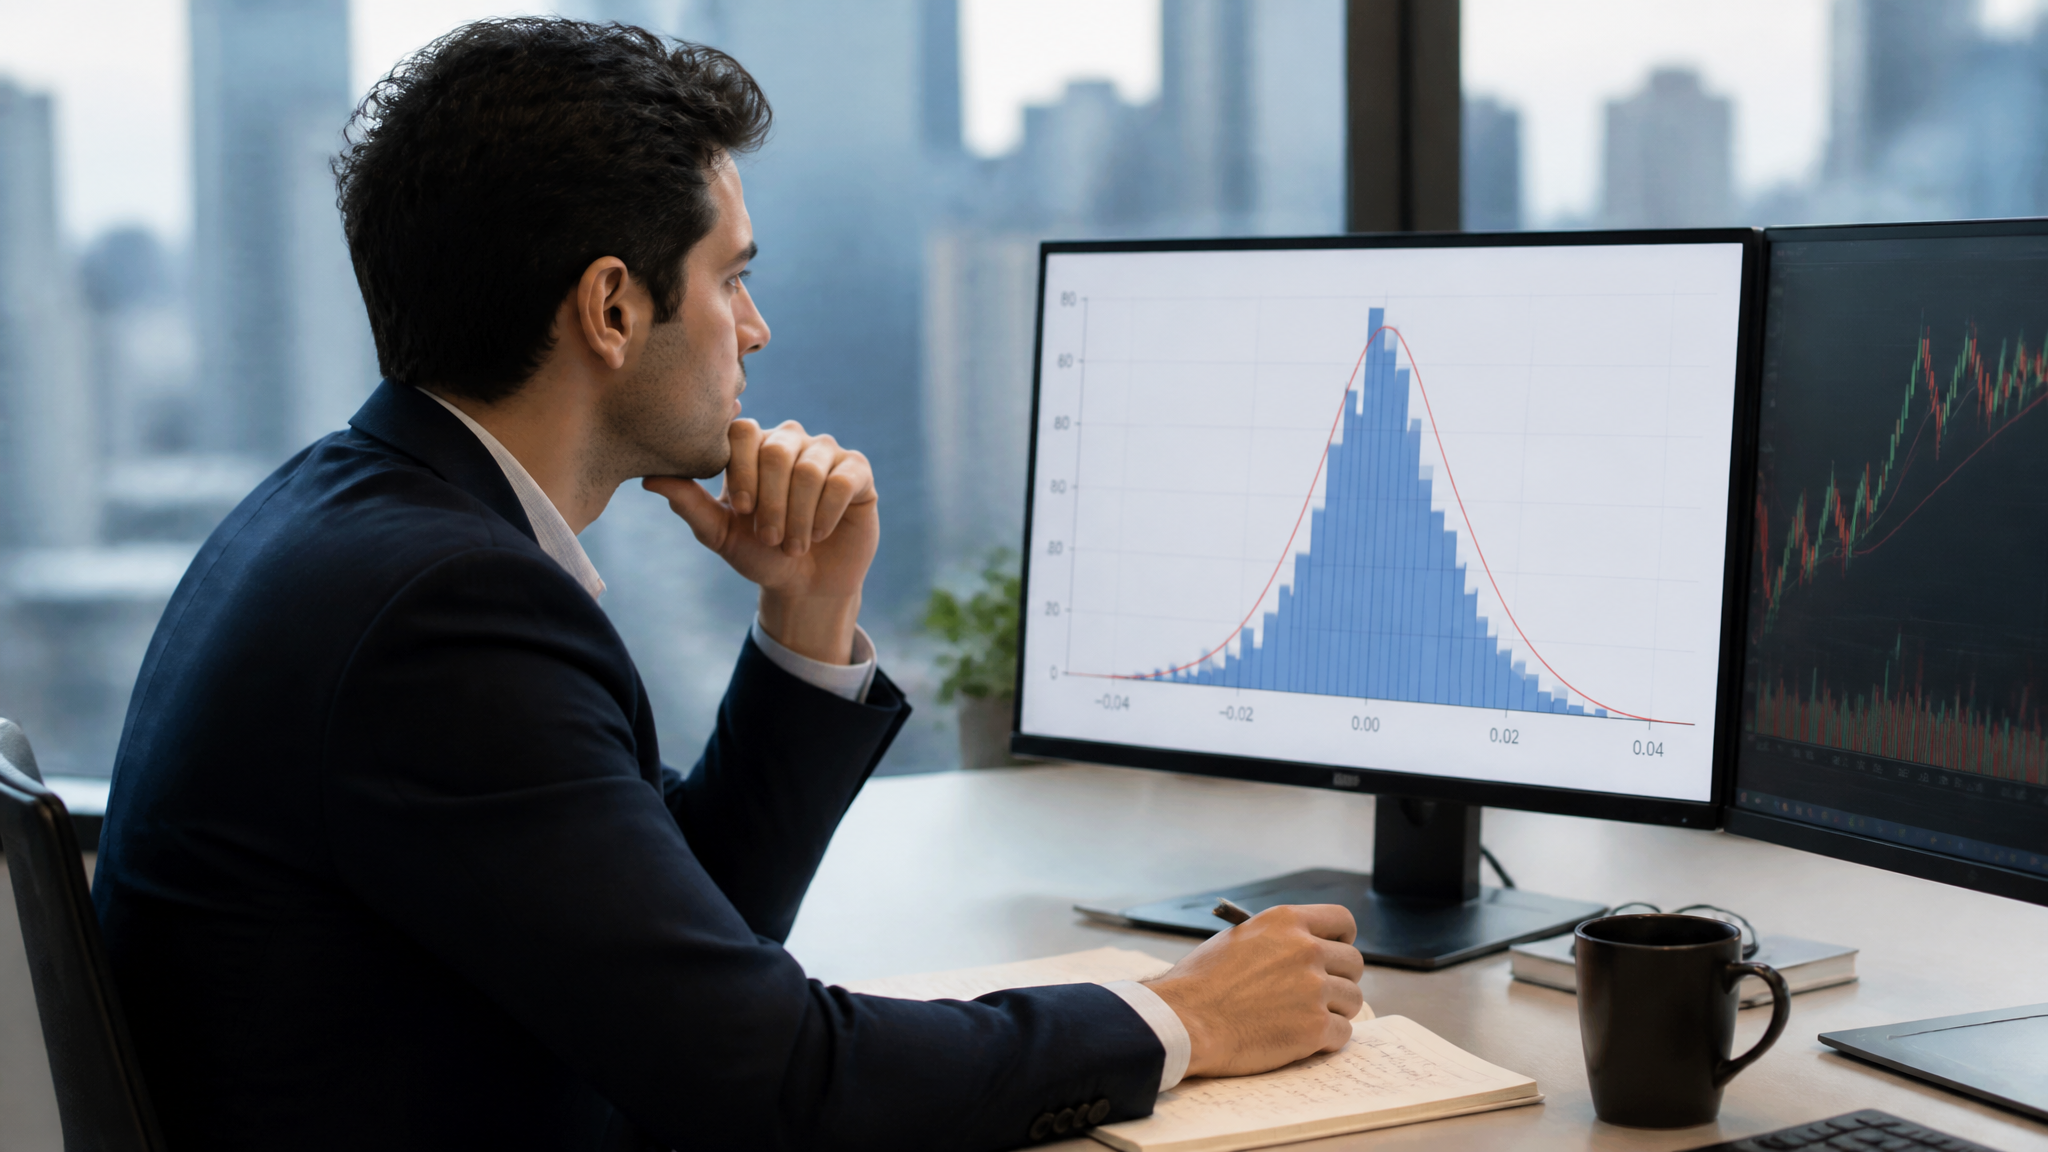
El análisis de rendimientos diarios es una de las bases del estudio cuantitativo en finanzas. Ya sea que evalúes un portafolio, un algoritmo de trading o simplemente quieras entender cómo se comporta un activo, el histograma de esos retornos te da una radiografía inmediata de su distribución: volatilidad, sesgo, colas anchas y más. Esta visualización, aparentemente simple, es el punto de partida para modelos de riesgo, backtesting y estrategias de cobertura.
En el entorno de la programación financiera, la consigna 'graficar un histograma de rendimientos diarios' aparece con frecuencia. En plataformas como HolaGPT, donde profesionales buscan soluciones de código rápidas y fiables, la respuesta a este tipo de prompts debe ser práctica pero rigurosa. En este artículo vas a seguir un flujo completo: desde la descarga de precios hasta un histograma con kernel density estimation (KDE) y estadísticos superpuestos. Todo con código que puedes copiar y ejecutar en tu propio entorno.
Qué son los rendimientos diarios y por qué un histograma
Un rendimiento diario mide el cambio porcentual del precio de un activo de un día al siguiente. La fórmula estándar usa el precio de cierre ajustado: rendimiento = (precio_hoy / precio_ayer) - 1. Muchos analistas prefieren el rendimiento logarítmico: r = ln(precio_hoy / precio_ayer), porque es aditivo en el tiempo y más simétrico. El histograma agrupa estos valores en 'bins' o cubetas y cuenta cuántas observaciones caen en cada intervalo. Así obtienes una imagen de la distribución empírica.
Esta representación gráfica revela de inmediato si los retornos son aproximadamente normales (campana simétrica) o si presentan asimetría y exceso de curtosis, características típicas de las series financieras. También permite identificar valores atípicos y comparar la dispersión entre distintos activos.
Preparación del entorno de trabajo
Necesitas Python 3.8 o superior y las bibliotecas pandas, numpy, matplotlib, seaborn y yfinance. Puedes instalarlas con pip:
pip install pandas numpy matplotlib seaborn yfinanceSi trabajas en un notebook de Jupyter, agrega %matplotlib inline al inicio para ver los gráficos embebidos. HolaGPT también puede ayudarte a configurar el entorno si tienes dudas específicas de compatibilidad o rutas de instalación.
Obtención de datos financieros reales
Usaremos yfinance para descargar los precios ajustados de cualquier ticker. Supongamos que queremos analizar Apple (AAPL) desde 2020 hasta hoy:
import yfinance as yf
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns

# Descargar datos
ticker = 'AAPL'
data = yf.download(ticker, start='2020-01-01', end='2024-12-31')
data.head()
El DataFrame contiene columnas como Open, High, Low, Close y Adj Close. La columna 'Adj Close' ajusta los precios por dividendos y splits; es la más recomendada para calcular rendimientos.
Cálculo de rendimientos diarios: simple vs logarítmico
Agregamos dos nuevas columnas: retorno simple y retorno logarítmico.
# Retorno simple
data['Return'] = data['Adj Close'].pct_change()

# Retorno logarítmico
data['Log_Return'] = np.log(data['Adj Close'] / data['Adj Close'].shift(1))

# Eliminar el primer NaN
data = data.dropna()
Para la mayoría de los análisis de corto plazo, la diferencia entre ambos métodos es pequeña, pero el retorno logarítmico tiene propiedades estadísticas más convenientes si después modelas con distribuciones normales. En nuestro caso, cualquiera funciona; elegiré el logarítmico para el ejemplo.
El primer histograma con matplotlib
Con unas pocas líneas generamos el gráfico básico:
plt.figure(figsize=(10,6))
plt.hist(data['Log_Return'], bins=50, color='#2196F3', edgecolor='white', alpha=0.8)
plt.title(f'Histograma de Rendimientos Diarios - {ticker}', fontsize=14, fontweight='bold')
plt.xlabel('Retorno logarítmico diario')
plt.ylabel('Frecuencia')
plt.grid(alpha=0.3, linestyle='--')
plt.tight_layout()
plt.show()
Este código produce una imagen limpia. El número de bins (50) es arbitrario; puedes ajustarlo según el tamaño de tu muestra. Una regla común es usar la raíz cuadrada del número de observaciones o el método de Sturges.
Elevando la calidad: KDE, bins dinámicos y color
Seaborn nos ofrece mayor control estético y agrega la curva de densidad con una sola función:
sns.set_style('whitegrid')
plt.figure(figsize=(12,7))
sns.histplot(data['Log_Return'], bins=60, kde=True, color='darkcyan', edgecolor='white', line_kws={'linewidth': 2, 'color': 'darkred'})
plt.title(f'Distribución de Rendimientos Diarios - {ticker}', fontsize=16, fontweight='bold')
plt.xlabel('Retorno logarítmico', fontsize=12)
plt.ylabel('Frecuencia', fontsize=12)
plt.tight_layout()
plt.show()
El parámetro kde=True activa la estimación de densidad kernel, que suaviza la distribución y facilita la comparación con una curva normal teórica. Los colores se eligieron para un alto contraste y legibilidad en reportes.
Interpretación estadística del histograma
Los retornos diarios suelen mostrar tres características:
- Media cercana a cero: en plazos cortos, el drift tiende a ser insignificante frente la volatilidad.
- Exceso de curtosis: más observaciones en los extremos de lo que predice una distribución normal. Las colas son anchas, señal de riesgo de eventos extremos.
- Asimetría: en mercados alcistas suele ser negativa (más caídas bruscas), aunque en acciones individuales puede variar.
Para cuantificar, podemos añadir líneas verticales con la media y desviaciones estándar:
mean = data['Log_Return'].mean()
std = data['Log_Return'].std()
plt.axvline(mean, color='black', linestyle='-', linewidth=2, label=f'Media: {mean:.5f}')
plt.axvline(mean + std, color='gray', linestyle='--', linewidth=1, label=f'+1 std')
plt.axvline(mean - std, color='gray', linestyle='--', linewidth=1, label=f'-1 std')
plt.axvline(mean + 2*std, color='silver', linestyle=':', linewidth=1, label=f'+2 std')
plt.axvline(mean - 2*std, color='silver', linestyle=':', linewidth=1, label=f'-2 std')
plt.legend()
Incluso puedes superponer la curva normal teórica con los mismos momentos:
from scipy.stats import norm
x = np.linspace(mean - 4*std, mean + 4*std, 100)
plt.plot(x, norm.pdf(x, mean, std), 'r--', label='Normal teórica')
Esto hace evidente la diferencia entre la realidad y el modelo teórico.
Comparación de varios activos en un mismo panel
Un análisis frecuente es contrastar la distribución de dos o más instrumentos. Si descargas datos de SPY (S&P 500 ETF) y TLT (bonos del tesoro), puedes crear una cuadrícula de histogramas o sobreponerlos con transparencia:
tickers = ['AAPL', 'SPY', 'TLT']
returns = pd.DataFrame()
for t in tickers:
    data = yf.download(t, start='2020-01-01', end='2024-12-31')
    returns[t] = np.log(data['Adj Close'] / data['Adj Close'].shift(1))
returns = returns.dropna()

plt.figure(figsize=(14,8))
for t in tickers:
    sns.histplot(returns[t], bins=60, kde=True, alpha=0.4, label=t)
plt.title('Comparativa de Distribuciones de Rendimientos Diarios')
plt.xlabel('Retorno logarítmico')
plt.legend()
plt.tight_layout()
plt.show()
La transparencia (alpha=0.4) evita que las barras se oculten entre sí. De un vistazo se aprecia que TLT (bonos) tiene menor volatilidad y una distribución más centrada, mientras que AAPL muestra colas más gruesas.
Visualización interactiva con Plotly
Para dashboards o reportes web, un gráfico estático puede quedarse corto. Plotly ofrece interactividad de manera sencilla:
import plotly.express as px
fig = px.histogram(data, x='Log_Return', nbins=60, marginal='box',
                   color_discrete_sequence=['mediumseagreen'])
fig.update_layout(title=f'Histograma Interactivo - {ticker}',
                  xaxis_title='Retorno logarítmico',
                  yaxis_title='Frecuencia',
                  bargap=0.05)
fig.show()
El parámetro marginal='box' añade un boxplot en el margen superior, enriqueciendo la información sobre cuartiles y valores atípicos. Puedes hacer zoom, desplazar y descargar la imagen como PNG. Esta alternativa es ideal cuando compartes resultados con colegas o clientes que no tienen acceso al código.
Errores comunes al graficar retornos diarios
1. No limpiar datos estáticos o fines de semana
Si tu fuente incluye días no bursátiles, el precio será constante y el retorno cero, lo que genera un pico artificial en el histograma. Asegúrate de que tus datos solo contengan días de operación. yfinance ya filtra automáticamente, pero otras APIs pueden requerir limpieza.
2. Usar precios no ajustados
Los splits y dividendos distorsionan los rendimientos si no se ajustan. Siempre emplea 'Adj Close' o una columna de precios ajustados. Si usas datos de fuentes no financieras, verifica la calidad.
3. Ignorar outliers
Eventos como crashes o noticias pueden producir retornos extremos. Decide si debes excluirlos (por ejemplo, para modelar con normalidad) o mantenerlos para análisis de riesgo. Un histograma con bins muy anchos puede esconder estos valores. Experimenta con diferentes resoluciones.
4. Escoger mal el número de bins
Pocos bins suavizan demasiado la distribución; muchos introducen ruido. Como regla práctica, usa bins='auto' en matplotlib o la regla de Freedman-Diaconis para distribuciones no normales.
5. Olvidar el contexto temporal
Los retornos diarios desde 2020 incluyen el shock COVID-19, lo que modifica la forma del histograma. Realiza análisis por subperiodos (pre-pandemia, post-pandemia) para entender cambios estructurales.
Automatización y consultas rápidas con HolaGPT
La consigna original, '¿Puedes graficar un histograma de rendimientos diarios?', es cada vez más común en asistentes de IA. En HolaGPT, los profesionales hispanohablantes pueden obtener este tipo de respuestas con código listo para ejecutar, ajustado a su stack tecnológico. Basta con detallar el ticker, el periodo y si necesitas interactividad. La plataforma devuelve el script completo y explicaciones, lo que acelera la exploración de datos sin tener que buscar en documentación dispersa.
Para proyectos recurrentes, puedes encapsular todo en una función:
def plot_daily_returns(ticker, start_date, end_date, log=True):
    data = yf.download(ticker, start=start_date, end=end_date)
    if log:
        data['Return'] = np.log(data['Adj Close'] / data['Adj Close'].shift(1))
    else:
        data['Return'] = data['Adj Close'].pct_change()
    data.dropna(inplace=True)

    plt.figure(figsize=(10,6))
    sns.histplot(data['Return'], bins=60, kde=True, color='steelblue')
    plt.title(f'Histograma de Rendimientos - {ticker}')
    plt.show()
    return data

data = plot_daily_returns('MSFT', '2019-01-01', '2024-12-31')
Con esta función, el análisis de múltiples activos se reduce a una línea. Los equipos de trading cuantitativo la integran en sus pipelines de backtesting para revisar la distribución de señales.
Aplicaciones del histograma más allá del equity
Aunque usamos acciones como ejemplo, el mismo flujo aplica a criptomonedas, materias primas o divisas. Los rendimientos diarios de Bitcoin, por ejemplo, muestran colas extremadamente gruesas y una asimetría negativa pronunciada, lo que el histograma capta con claridad. Además, puedes extender el concepto a rendimientos intradiarios con datos de 1 hora o 5 minutos; solo cambia la frecuencia de muestreo. Esta versatilidad convierte el histograma en una herramienta universal del cuant.
Integración con dashboards y reportes automatizados
Para compartir resultados con no programadores, puedes embeber el gráfico en un PDF con LaTeX o en una aplicación web con Streamlit. Un ejemplo mínimo con Streamlit:
import streamlit as st
import yfinance as yf
import plotly.express as px

st.title('Analizador de Rendimientos Diarios')
ticker = st.text_input('Ticker', 'AAPL')
data = yf.download(ticker, period='5y')
data['Log_Return'] = np.log(data['Adj Close'] / data['Adj Close'].shift(1))
data.dropna(inplace=True)

fig = px.histogram(data, x='Log_Return', nbins=80, title='Histograma de Log-Retornos')
st.plotly_chart(fig)
Así, cualquier usuario del equipo puede explorar distintos activos sin tocar código, aprovechando la misma lógica de cálculo que hemos detallado.
Conclusión
Graficar un histograma de rendimientos diarios no es solo una tarea de visualización: es un diagnóstico de la naturaleza del activo. Con Python, pandas, matplotlib y seaborn (o plotly) tienes un control total sobre cada detalle, desde los bins hasta la superposición de estadísticos. Hemos recorrido la sintaxis básica, la interpretación de resultados y las precauciones para no caer en errores comunes.
La práctica constante te llevará a reconocer patrones de volatilidad, agrupamiento de retornos y la presencia de eventos extremos con un simple vistazo. Si necesitas respuestas rápidas, recuerda que HolaGPT puede resolver este y otros prompts relacionados, devolviéndote código listo para implementar, adaptado a tu caso concreto. Integra esta herramienta en tu flujo de análisis financiero y acelera la curva de aprendizaje.