Correlación Cruzada: Guía Práctica para Calcular y Graficar con Python
Domina el análisis de similitud entre señales y series temporales con herramientas reales.
Por Jose Luis Rueda · 10 min lectura · 2026-07-19
Un colega te pregunta: «¿Puedes calcular y trazar la correlación cruzada de estos datos?». No es una petición trivial. Detrás de esa frase se esconde la necesidad de encontrar relaciones ocultas entre dos series temporales, detectar retardos o validar modelos. La correlación cruzada es una de las herramientas más subestimadas en el arsenal de un profesional de datos. Este artículo te da todo lo que necesitas para responder con exactitud a esa pregunta, desde el fundamento matemático hasta el código listo para usar.
No importa si trabajas con señales de audio, cotizaciones bursátiles o sensores industriales. La correlación cruzada te permite medir la similitud entre dos conjuntos de datos en función del desplazamiento de uno respecto al otro. En otras palabras, te muestra cuándo y cómo se copian dos series. Aquí te explicaré cómo calcularla, graficarla e interpretarla con Python, usando ejemplos reales y evitando la paja académica.
Si buscas una guía directa, escrita por un profesional para profesionales, este es el lugar. Sin frases de relleno, sin magia. Solo código, gráficos y criterio.
Qué es la correlación cruzada y por qué deberías usarla
La correlación cruzada mide la similitud entre dos señales a medida que una se desplaza en el tiempo respecto a la otra. El resultado es una función que depende del retardo (lag). Un pico en un lag positivo significa que la primera señal se adelanta a la segunda, un pico en lag negativo indica lo contrario. No es un concepto nuevo, ingenieros de telecomunicaciones lo usan desde hace décadas para sincronizar relojes y detectar ecos.
En el mundo de los datos moderno, esta herramienta resuelve problemas concretos: encontrar el desfase entre la inversión en publicidad y las ventas, alinear múltiples sensores en una planta, identificar plagios en audio o detectar patrones repetitivos en logs de servidores. Su expresión matemática para señales discretas x e y, con N muestras, es: R_xy[k] = sum_{n} x[n] * y[n+k] (suponiendo que ambas son finitas y con relleno de ceros cuando sea necesario). Si quieres un enfoque más robusto, se normaliza dividiendo por el producto de las energías, obteniendo el coeficiente de correlación cruzada normalizado, que va de -1 a 1.
La implementación directa con bucles es lenta. La transformada rápida de Fourier (FFT) acelera el cálculo hasta O(N log N) mediante el teorema de convolución: la correlación cruzada se convierte en el producto de la FFT de una señal por el conjugado de la otra. Por eso, bibliotecas como NumPy y SciPy usan este truco.
A lo largo del artículo usaremos Python, por ser el estándar de facto en análisis de datos. Pero los conceptos aplican a cualquier lenguaje.
Preparación del entorno y datos de ejemplo
Vamos a crear dos señales sintéticas con un desfase conocido para comprobar que el cálculo funciona. Usaremos una sinusoide más ruido, y una versión desplazada. Esto nos servirá para verificar la detección del lag.
import numpy as np
import matplotlib.pyplot as plt
import scipy.signal as signal

# Semilla para reproducibilidad
np.random.seed(42)
# 500 puntos, sinusoide de 5 Hz, muestreada a 100 Hz
fs = 100
t = np.arange(500) / fs
f = 5
senal1 = np.sin(2 * np.pi * f * t) + 0.2 * np.random.randn(500)
# Señal2 idéntica pero desplazada 40 muestras (0.4 segundos)
desfase = 40
senal2 = np.roll(senal1, desfase)
# Añadir ruido independiente extra a senal2 para simular un caso real
senal2 += 0.1 * np.random.randn(500)
Con este par, la correlación cruzada debería mostrar un pico máximo en el lag 40. Si no, algo falla. Los datos están listos.
Cálculo de la correlación cruzada con NumPy o SciPy
NumPy ofrece np.correlate. Por defecto calcula la correlación cruzada lineal completa, devolviendo un array de longitud len(x)+len(y)-1. El parámetro mode='full' da todos los lags posibles, 'same' recorta al tamaño de la entrada mayor, y 'valid' sin relleno de ceros. Para análisis de señales, 'full' es el más usado porque permite ver todos los desplazamientos.
# Correlación cruzada 'full'
corr_full = np.correlate(senal1, senal2, mode='full')
lags = np.arange(-len(senal2)+1, len(senal1))  # lags en índices
# Nota: el orden de las entradas afecta la dirección del lag.
# Con np.correlate(a, b) un pico positivo en los lags positivos significa que a está desplazada adelante.
Sin embargo, np.correlate no normaliza y en arrays grandes puede consumir mucha memoria. SciPy ofrece scipy.signal.correlate con métodos basados en FFT (method='fft') mucho más rápidos, además de scipy.signal.correlation_lags para generar el vector de lags automáticamente.
from scipy.signal import correlate, correlation_lags
corr = correlate(senal1, senal2, mode='full', method='fft')
lags = correlation_lags(len(senal1), len(senal2), mode='full')
# Encontrar el lag del pico máximo
lag_max = lags[np.argmax(corr)]
print(f'Lag máximo: {lag_max}')  # Debe imprimir 40
Normalización y sesgo estadístico
Usar la correlación bruta es un error común. A medida que el lag se aleja de cero, el número de términos que se solapan disminuye, lo que reduce artificialmente la magnitud. Esto puede ocultar picos reales. La normalización divide cada punto por la raíz cuadrada del producto de las energías de los segmentos efectivamente solapados. SciPy no incluye un modo automático para esto, pero puedes implementarlo:
def correlacion_normalizada(x, y):
    n = len(x)
    result = np.zeros(2*n - 1)
    for k in range(-n+1, n):
        idx = k + n - 1
        if k < 0:
            x_seg = x[-k:]
            y_seg = y[:len(x_seg)]
        else:
            x_seg = x[:n-k]
            y_seg = y[k:]
        if len(x_seg) > 0:
            result[idx] = np.corrcoef(x_seg, y_seg)[0,1]
    return result
# Cuidado con el rendimiento; para señales largas, usa FFT y ventana de normalización.
Para grandes volúmenes, una aproximación es usar la correlación circular con relleno de ceros (zero-padding) para evitar caídas, pero la interpretación física cambia. En series temporales financieras, se suele mantener solo la región sin pérdida de solapamiento, es decir, el segmento central.
Graficar la correlación cruzada: del dato crudo a una visualización profesional
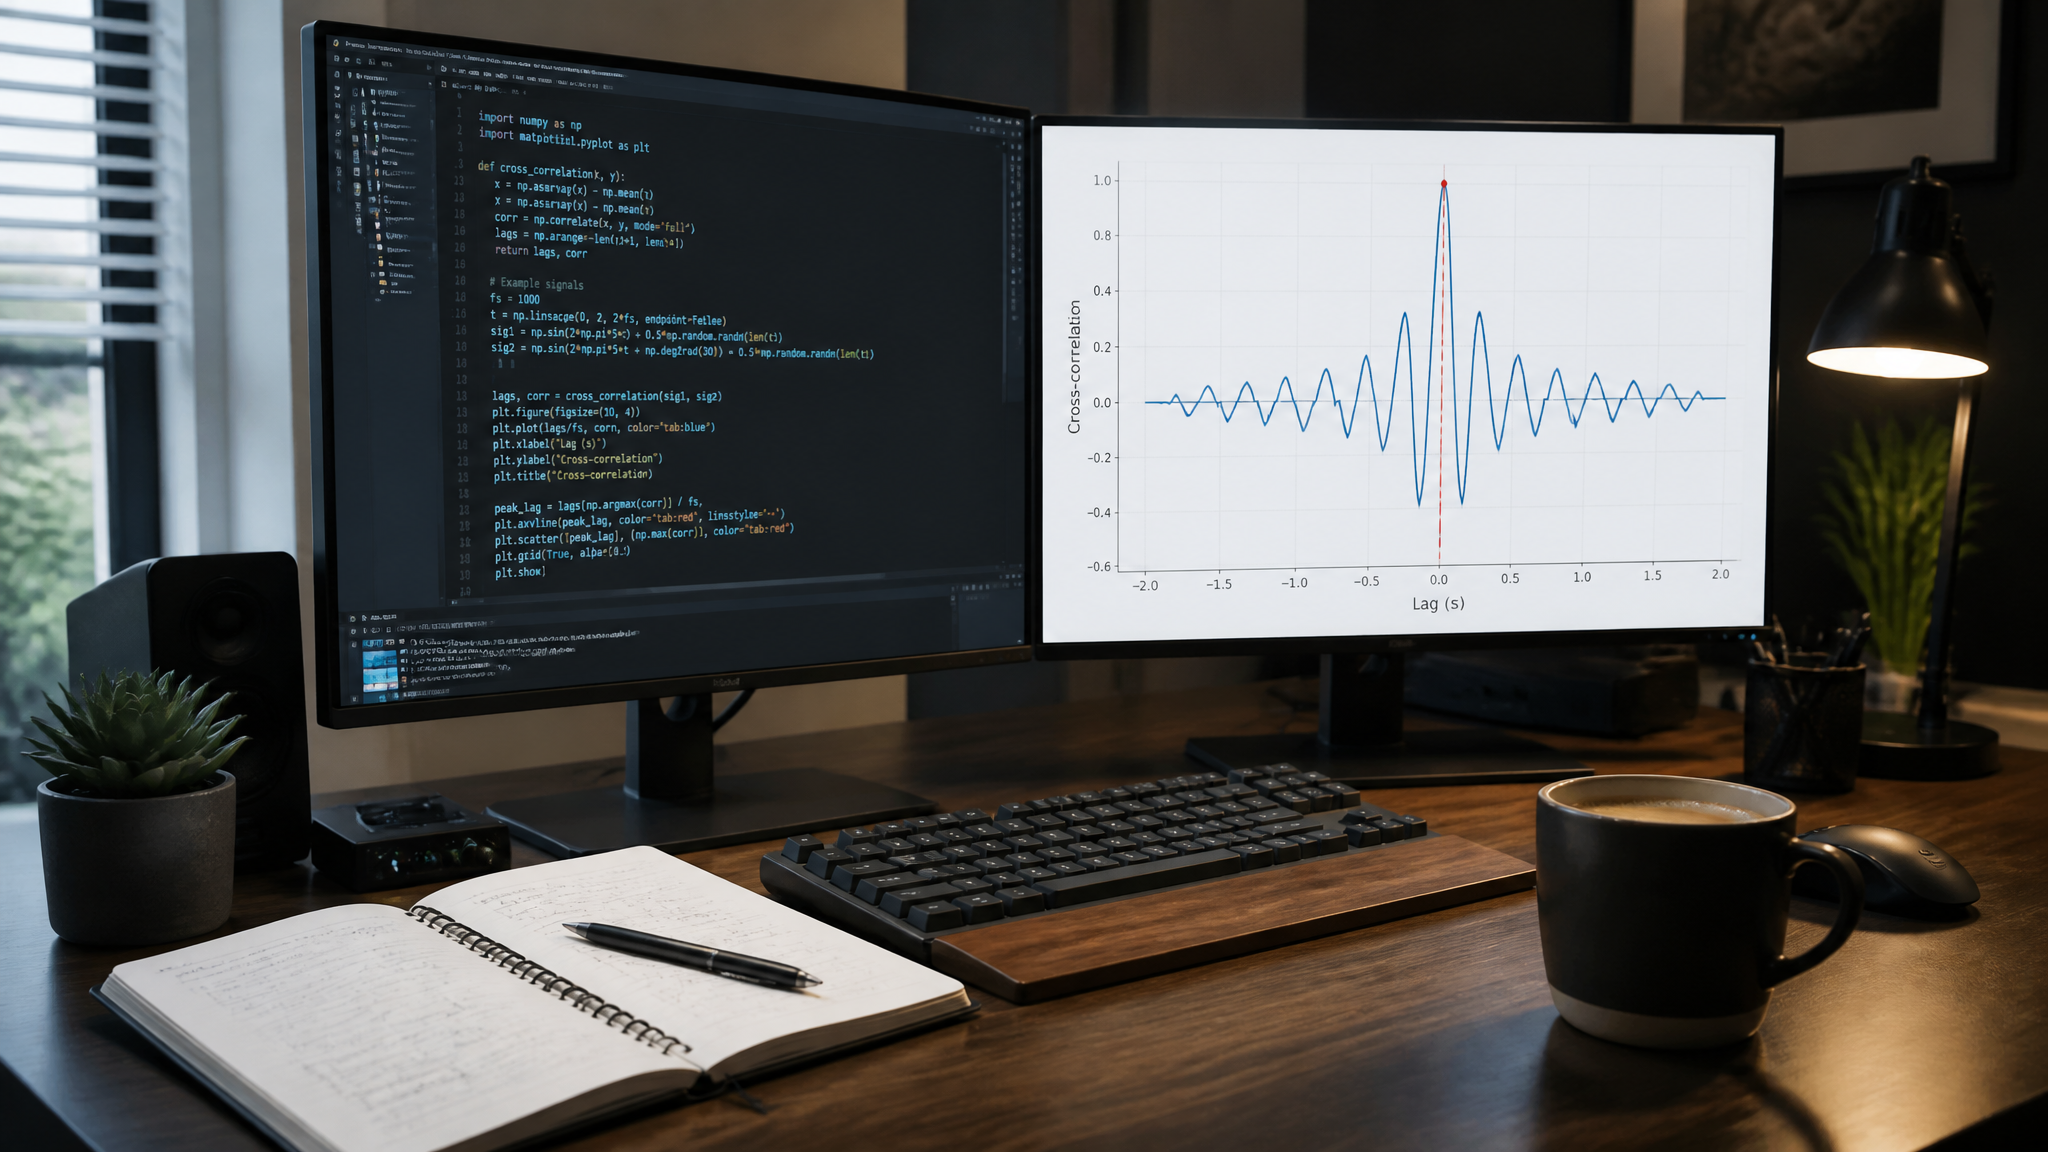
Un gráfico mal hecho entierra la información. Debe incluir etiquetas claras, línea vertical en el lag del máximo y, si procede, bandas de confianza para descartar correlaciones espurias. Usamos matplotlib.
plt.figure(figsize=(12, 5))
plt.plot(lags, corr, color='steelblue', linewidth=1.2)
plt.axvline(lag_max, color='crimson', linestyle='--', alpha=0.7, label=f'Máximo en lag={lag_max}')
# Añadir umbral de significancia (por ejemplo, ±2/√N como regla rápida para ruido blanco)
umbral = 2 / np.sqrt(len(senal1))
plt.axhline(umbral, color='gray', linestyle=':', alpha=0.8)
plt.axhline(-umbral, color='gray', linestyle=':', alpha=0.8)
plt.xlabel('Lag (muestras)')
plt.ylabel('Correlación bruta')
plt.title('Correlación cruzada entre senal1 y senal2')
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
Si quieres el coeficiente de correlación normalizado, tras aplicar la normalización, el gráfico oscilará entre -1 y 1, y los umbrales de significancia se interpretan directamente.
Aplicaciones prácticas con datos reales
Un ejemplo muy demandado: medir el retardo entre el gasto en marketing y los ingresos. Supón que tienes dos series mensuales: inversión publicitaria (en miles) y ventas (en miles), ambas de 36 meses. Calculando la correlación cruzada podrías descubrir que las ventas reaccionan con un desfase de 2 meses. Ese hallazgo permite ajustar presupuestos y predecir flujos de caja. El código es el mismo; solo cambian los datos.
Otro caso: en IoT industrial, dos sensores de vibración separados físicamente registran una misma perturbación. La diferencia de tiempo de llegada (Time Difference of Arrival, TDOA) se obtiene del pico de correlación cruzada. Este principio localiza fugas en tuberías o monitoriza maquinaria rotativa.
En finanzas cuantitativas, los traders buscan cointegración y lead-lag entre activos. La correlación cruzada de los rendimientos logarítmicos indica si un activo anticipa el movimiento de otro. Combinado con pruebas estadísticas, se filtran falsas correlaciones.
Evitar trampas: desventajas y errores frecuentes
La correlación cruzada no implica causalidad. Un pico alto en un lag puede deberse a tendencias comunes, estacionalidad o ruido. Siempre aplica diferenciación a las series si no son estacionarias, y comprueba la significancia mediante remuestreo (bootstrap) o usando el estadístico de correlación de Pearson con corrección de Bonferroni.
Otro fallo típico: ignorar el sesgo de los extremos. Si analizas solo la zona central de la correlación, es posible que pierdas relaciones de largo retardo. Pero si usas la salida completa, la caída de energía puede malinterpretarse. Decide según el contexto. En alineación de secuencias biológicas, por ejemplo, se usa el algoritmo de Needleman-Wunsch, más adecuado que la correlación cruzada cruda.
El tamaño de la muestra importa. Con series cortas, un pico aparentemente grande puede ser aleatorio. Usa intervalos de confianza generados por Montecarlo: permuta aleatoriamente una de las series, recalcula la correlación muchas veces y toma el percentil 95 como umbral.
Integrando HolaGPT para acelerar el análisis
Como profesional, sabes que escribir estos scripts desde cero cada vez consume tiempo. Plataformas como HolaGPT te permiten generar, depurar y personalizar código de correlación cruzada con solo describir el problema. Puedes pedir: «Genera una función que calcule la correlación cruzada normalizada de dos DataFrames de pandas y grafique el resultado con bandas de significancia al 95%». Obtendrás una implementación lista, con explicaciones, que luego adaptas a tu entorno. Esta capacidad reduce la fricción técnica y te devuelve horas para el análisis estratégico.
Además, HolaGPT puede sugerir interpretaciones basadas en patrones comunes, vinculando los resultados con tu dominio de negocio. No reemplaza el criterio humano, pero sí elimina el trabajo repetitivo y los errores de sintaxis. En un sector donde la velocidad de respuesta marca la diferencia, estas herramientas se convierten en aliadas.
Ampliación: correlación cruzada en múltiples dimensiones
Si trabajas con imágenes, la correlación cruzada 2D es la base del template matching. OpenCV y SciPy ndimage incluyen funciones optimizadas. El principio es el mismo: deslizas una plantilla sobre una imagen y mides la similitud local. Detectas objetos, alineas fotografías aéreas o registras imágenes médicas. La implementación en Python es directa:
from scipy.signal import correlate2d
# imagen: array 2D grande, template: subarray
resultado = correlate2d(imagen, template, mode='same')
# El pico indica la posición de máxima coincidencia
En deep learning, la capa de convolución es un tipo especializado de correlación cruzada. Conocer el fundamento te da una intuición más sólida para diseñar arquitecturas.
Conclusión
Calcular y graficar la correlación cruzada de tus datos es más que una línea de código. Implica entender el método, normalizarlo, interpretarlo con cautela y presentarlo con claridad. Python, con NumPy y SciPy, ofrece todo lo necesario para ejecutar estas tareas con eficiencia. Desde la detección de retardos en señales sintéticas hasta aplicaciones en finanzas o IoT, el patrón es el mismo: calcula, normaliza, valida y comunica.
La próxima vez que alguien te pida «calcular y trazar la correlación cruzada», no solo sabrás responder. Entregarás un análisis que aporta valor real. Y con asistentes como HolaGPT a tu lado, el camino del dato al conocimiento se acorta drásticamente.