Descomponer imágenes en objetos: guía práctica para profesionales con IA
Segmentación, extracción de objetos y aplicaciones reales para acelerar tus proyectos visuales
Por Jose Luis Rueda · 12 min lectura · 2026-07-13
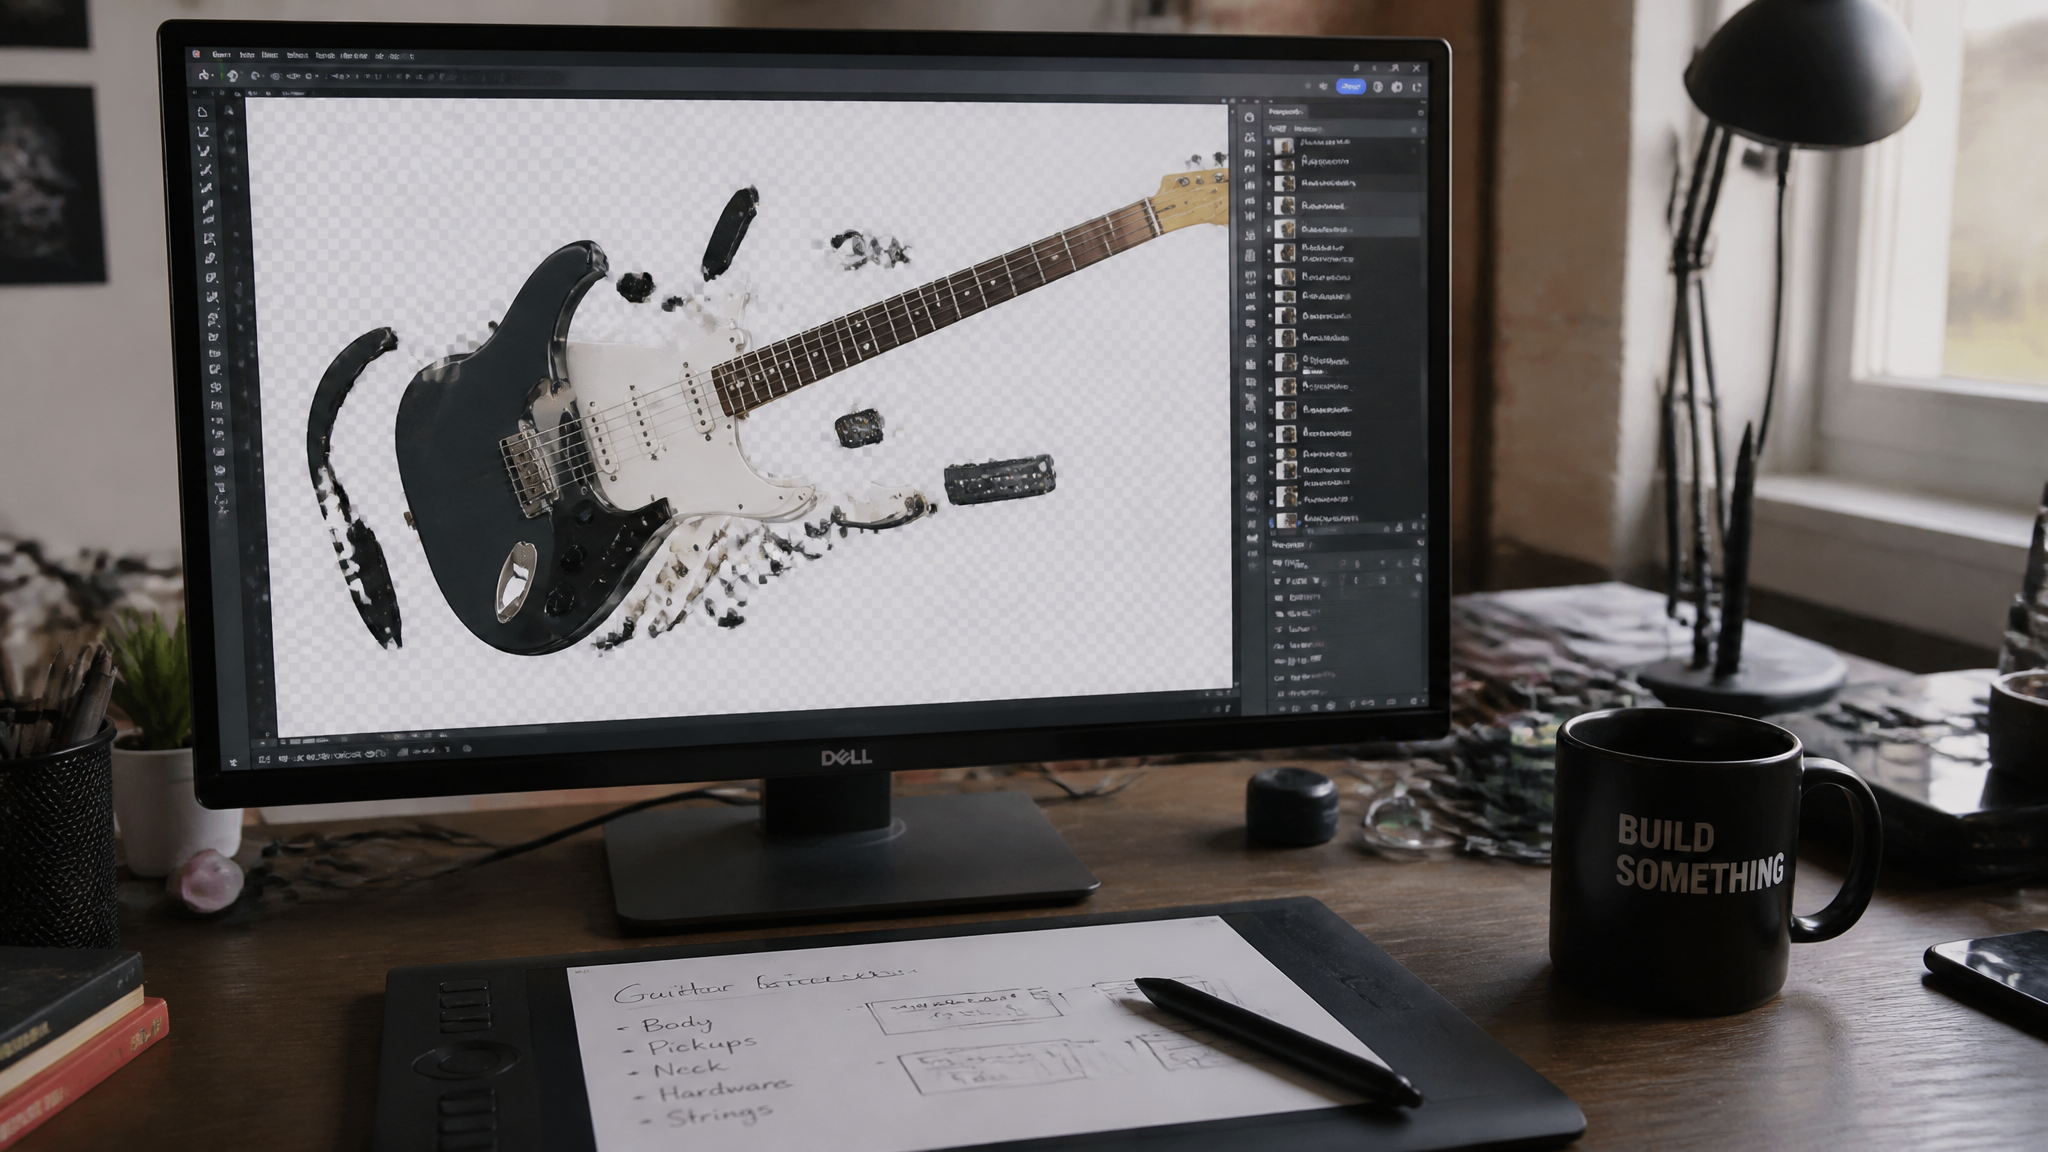
Un diseñador recibe 50 fotos de producto y necesita eliminar el fondo de cada una, aislar el artículo y guardar versiones con distintos colores. Un ingeniero de datos entrena un modelo para reconocer piezas defectuosas en una línea de montaje. Un cirujano quiere delimitar un tumor en una tomografía. Las tres situaciones exigen lo mismo: descomponer una imagen en sus objetos separados. Lo que antes requería horas de trabajo manual ahora se resuelve con modelos de inteligencia artificial que segmentan, recortan y aíslan cada elemento de una escena.
Desde las primeras redes convolucionales hasta arquitecturas como Mask R-CNN o Segment Anything Model (SAM), el campo ha madurado hasta volverse accesible. Plataformas como HolaGPT integran estas capacidades en interfaces sencillas, lo que permite a profesionales sin perfil técnico ejecutar la descomposición en segundos. En este artículo recorremos los fundamentos, las herramientas y las implementaciones prácticas, sin rodeos.
Veremos qué significa exactamente descomponer una imagen, las diferencias entre detección, segmentación semántica y segmentación por instancias, y cómo aplicar cada técnica según el caso. Además, mostraremos ejemplos con código y exploraremos casos de uso que van desde el e‑commerce hasta la medicina. Si buscas acelerar tus flujos de trabajo con imágenes, esta guía te dará el mapa completo.
1. Qué implica descomponer una imagen
Descomponer una imagen significa identificar y separar cada objeto o región significativa que la compone. En lugar de analizar la foto como un todo, el objetivo es extraer máscaras binarias (o recortes) que representen cada elemento: una persona, un coche, una taza, el cielo, el suelo. Esto permite trabajar con partes aisladas, modificar fondos, contar instancias o analizar atributos locales.
El proceso se apoya en la segmentación de imágenes, una rama clásica de la visión artificial que la IA ha transformado. Los modelos actuales no solo distinguen categorías, también generan contornos precisos a nivel de píxel. La descomposición puede ser semántica (todos los píxeles de la misma clase se agrupan sin diferenciar instancias) o por instancias (cada objeto individual recibe una etiqueta única). Elegir una u otra depende del resultado que necesites.
Segmentación semántica vs. segmentación por instancias
La segmentación semántica asigna una etiqueta de clase a cada píxel. Por ejemplo, en una foto de una calle, todo el asfalto se marca como 'carretera', todos los peatones como 'persona', sin distinguir entre el peatón A y el B. Modelos como DeepLab o U‑Net dominan esta tarea.
La segmentación por instancias va más allá: detecta objetos individuales y genera una máscara precisa para cada uno. Mask R‑CNN es el referente. Detecta personas, coches o perros y los separa aunque estén superpuestos. Esto es lo que realmente necesitas cuando quieres aislar cada elemento como un archivo independiente.
Existe una tercera variante, la segmentación panóptica, que combina ambas: clasifica cada píxel con una clase y, para las clases que son 'cosas' (objetos contables), asigna una instancia. Es la más completa, pero también la más costosa computacionalmente.
2. Arquitecturas de IA que hacen posible la magia
Detrás de cada descomposición hay una red neuronal entrenada con millones de imágenes anotadas. Las arquitecturas más relevantes hoy son:
- Mask R‑CNN: Extiende Faster R‑CNN añadiendo una rama para predecir máscaras de segmentación sobre cada región propuesta. Es robusta, precisa y base de muchos sistemas de producción.
- U‑Net: Diseñada originalmente para imágenes médicas, su estructura de encoder‑decoder con saltos de conexión la vuelve excelente para segmentación semántica con pocos datos de entrenamiento.
- YOLOv8‑seg: La familia YOLO ha incorporado segmentación por instancias en tiempo real. Ideal para aplicaciones que requieren velocidad, como conteo de personas o monitoreo industrial.
- SAM (Segment Anything Model): Desarrollado por Meta, es un modelo de segmentación de propósito general que genera máscaras a partir de puntos, cajas o texto. Su flexibilidad permite descomponer imágenes sin entrenamiento previo específico. Es un punto de inflexión para tareas rápidas.
- MobileNet + DeepLab: Combinación ligera para segmentación semántica en dispositivos móviles o navegadores.
Cada arquitectura tiene un equilibrio entre precisión y coste computacional. En la nube, un modelo como SAM puede ejecutarse bajo demanda; en un teléfono, MobileNet segmenta el fondo en videollamadas sin gastar batería.
3. Herramientas y plataformas para descomponer imágenes
No hace falta ser ingeniero de machine learning para usar estos modelos. Existen APIs, servicios gestionados y plataformas no‑code que exponen la funcionalidad.
APIs de segmentación en la nube
Los grandes proveedores cloud ofrecen endpoints:
- Google Cloud Vision API: Detecta objetos y proporciona bounding boxes, pero su segmentación a nivel de píxel es limitada. Para máscaras finas necesitas AutoML Vision.
- AWS Rekognition: Similar, orientado a moderación y detección de caras, no a segmentación avanzada.
- Azure Custom Vision: Permite entrenar modelos de segmentación semántica con tus propias imágenes. Más control, pero requiere datos etiquetados.
Plataformas integradas como HolaGPT
La oferta de HolaGPT simplifica radicalmente el acceso. Dentro de su módulo de visión artificial, puedes enviar una imagen y recibir en segundos una descomposición completa: máscaras, objetos recortados y un JSON estructurado con las coordenadas y clases. No necesitas escribir una línea de código. Esto es especialmente útil para equipos de marketing que preparan catálogos, estudios de arquitectura que analizan planos o startups que construyen MVPs sin contratar especialistas en IA. La plataforma utiliza internamente modelos como SAM y Mask R‑CNN, optimizados para velocidad, y te evita gestionar instancias GPU.
Herramientas de escritorio y librerías open‑source
Si prefieres trabajar en local, el ecosistema Python ofrece:
- Segment Anything Model (SAM) + ONNX: El modelo de Meta disponible en PyTorch o convertido a ONNX para ejecución eficiente.
- Detectron2: Framework de Facebook AI Research que implementa Mask R‑CNN y otras arquitecturas. Muy modular, pero con curva de aprendizaje.
- MMSegmentation: Biblioteca de segmentación semántica con decenas de modelos preentrenados.
- rembg: Librería especializada en eliminar fondos. Útil para descomposición sencilla de objetos frontales.
En el escritorio, GIMP con complementos de IA, Adobe Photoshop (con su selección de objeto mejorada por IA) o Luminar Neo ofrecen herramientas interactivas que aplican segmentación, aunque sin la posibilidad de automatizar lotes completos como haría una API.
4. Implementación práctica: separar objetos con Python en 10 minutos
Vamos a un ejemplo real. Usaremos Hugging Face Transformers y el modelo DETR (Detection Transformer) con segmentación por instancias. Este snippet aísla cada objeto detectado en archivos PNG individuales con fondo transparente.
from transformers import DetrFeatureExtractor, DetrForSegmentation
from PIL import Image, ImageDraw
import requests, torch, numpy as np

# Cargar modelo y feature extractor de DETR con segmentación
feature_extractor = DetrFeatureExtractor.from_pretrained('facebook/detr-resnet-50-panoptic')
model = DetrForSegmentation.from_pretrained('facebook/detr-resnet-50-panoptic')

# Descargar imagen de ejemplo
url = 'https://ejemplo.com/foto.jpg'
image = Image.open(requests.get(url, stream=True).raw)

# Preprocesar
inputs = feature_extractor(images=image, return_tensors='pt')

# Inferencia
outputs = model(**inputs)

# Obtener máscaras y etiquetas
# outputs.pred_masks: tensor de forma [num_queries, H/4, W/4]
# Redimensionar a tamaño original (aprox.) y binarizar
masks = torch.sigmoid(outputs.pred_masks.squeeze(0)) > 0.5
for i, mask in enumerate(masks):
    mask_np = mask.detach().cpu().numpy().astype(np.uint8) * 255
    # Convertir la máscara a imagen PIL
    mask_img = Image.fromarray(mask_np).resize(image.size, resample=Image.NEAREST)
    # Aplicar máscara al canal alpha
    object_image = image.copy()
    object_image.putalpha(mask_img)
    object_image.save(f'objeto_{i}.png')
Este código utiliza DETR panóptico, que devuelve tanto máscaras de instancias como semánticas. Para un proyecto más ligero, el modelo detr-resnet-50-panoptic ofrece un buen equilibrio. Si necesitas máxima precisión con objetos pequeños, Mask R‑CNN vía Detectron2 da mejores resultados, pero con mayor latencia.
Si no quieres lidiar con dependencias de PyTorch, HolaGPT expone un endpoint REST que devuelve JSON con las URLs de cada recorte. Con una llamada POST puedes automatizar flujos completos sin instalar nada:
curl -X POST https://api.holagpt.com/v1/image/decompose \
  -H 'Authorization: Bearer TU_API_KEY' \
  -F '[email protected]' \
  -F 'mode=instance' \
  -o resultado.json
El JSON resultante incluye una lista de objetos con bounding box, clase, puntuación de confianza y enlace a la imagen recortada en PNG. Así se integra en cualquier backend en minutos.
5. Casos de uso que justifican el esfuerzo
La descomposición de imágenes deja de ser un ejercicio académico cuando ves el retorno concreto.
E‑commerce y catálogos digitales
El 93 % de los compradores online considera las imágenes de producto como el factor decisivo, según eMarketer. Aislar el producto permite reemplazar fondos, generar variantes de color y crear fichas homogéneas. Con segmentación automatizada, un estudio fotográfico procesa 3000 imágenes diarias con un solo operario. Plataformas como HolaGPT incluyen pre‑ajustes para eliminar fondo y extraer el objeto principal a alta resolución, incluso con bordes difíciles como pelo o cristal.
Medicina y análisis de imágenes diagnósticas
En radiología, descomponer una resonancia sirve para aislar órganos, detectar lesiones y medir volúmenes. U‑Net es el estándar de facto. Investigadores están entrenando variantes que segmentan células cancerígenas en tiempo real durante una cirugía asistida por imagen. La descomposición aquí es crítica: cada píxel erróneo puede llevar a un diagnóstico equivocado.
Industria 4.0 y control de calidad
En una fábrica, una cámara captura cada pieza en la cadena de montaje. La IA descompone la imagen para comprobar dimensiones, detectar rayones o verificar el montaje de componentes. La velocidad de inferencia es clave. Modelos como YOLOv8‑seg permiten inspeccionar 60 piezas por segundo en hardware accesible.
Automoción autónoma
Un coche autónomo debe descomponer la escena vial en peatones, señales, otros vehículos y calzada, todo en milisegundos. Las arquitecturas panópticas (EfficientPS, Panoptic FPN) se diseñaron para este propósito, y muchas se entrenan con datasets como Cityscapes.
Arte digital y realidad aumentada
Crear un filtro de Instagram que reaccione al cuerpo requiere separar la silueta de la persona del entorno. La segmentación en tiempo real (MediaPipe, ML Kit) permite extraer la silueta y superponer efectos. Programas como RunwayML utilizan descomposición para que artistas generen contenido interactivo sin programar.
6. Desafíos reales que encontrarás
Aunque los modelos actuales son impresionantes, todavía hay dificultades:
- Objetos parcialmente ocultos: Cuando un objeto tapa otro, el modelo debe inferir la forma completa. SAM y Mask R‑CNN manejan oclusiones moderadas, pero no son perfectos.
- Bordes finos y texturas complejas: Pelos, encajes o fuego generan máscaras imprecisas. A menudo se requieren técnicas de refinamiento (CRF, matting).
- Iluminación variable: Sombras duras o reflejos engañan al modelo. Aumentar el dataset con variaciones de luz ayuda durante el entrenamiento, pero en inferencia puede fallar.
- Desempeño en tiempo real: Segmentar una imagen 4K con Mask R‑CNN toma cientos de milisegundos en GPU. Para video en vivo, hay que recortar resoluciones o usar redes más ligeras.
- Interpretación semántica errónea: Un modelo puede confundir una escultura de perro con un animal real. El contexto importa. Los modelos multimodales (CLIP + SAM) mitigan esto al aceptar prompts de texto.
Para aplicaciones profesionales, la clave es elegir el equilibrio adecuado entre precisión y velocidad, y contemplar un flujo de validación humana para los casos ambiguos. Con HolaGPT, puedes configurar reglas de confianza mínima y derivar imágenes con baja puntuación a revisión manual, combinando lo mejor de la IA con el criterio humano.
7. Optimización y buenas prácticas
Si estás montando un pipeline que descompone miles de imágenes al día, sigue estas recomendaciones:
- Preprocesamiento inteligente: Redimensiona las imágenes al tamaño óptimo del modelo antes de la inferencia. Muchas redes trabajan con 640x640 o 1024x1024. Evita redimensionados innecesarios; guarda las máscaras y luego escala las coordenadas al tamaño original.
- Guarda metadatos estructurados: Almacena las máscaras en formato RLE (Run‑Length Encoding) o como PNG indexado para ahorrar espacio. Adjunta la clase y confianza en una base de datos ligera (SQLite, DynamoDB) para búsquedas rápidas.
- Usa lotes (batch processing): Las GPUs rinden mejor con varias imágenes a la vez. Agrupa solicitudes en colas y procesa en bloques de 8 o 16 imágenes.
- Cachea resultados: Si una misma imagen se procesa repetidas veces, guarda el hash y reutiliza la descomposición. Ahorrarás cómputo y costes.
- Monitorea la deriva de datos: Si el tipo de imágenes que recibes cambia (por ejemplo, nuevos productos con envases diferentes), el rendimiento del modelo puede degradarse. Configura alertas cuando la confianza promedio baje de un umbral.
8. El futuro de la descomposición de imágenes
La tendencia apunta a modelos fundacionales multimodales que segmentan siguiendo instrucciones en lenguaje natural. Con SAM 2 se espera capacidades de video, segmentando objetos a lo largo de fotogramas con un solo clic. La combinación de visión‑lenguaje (GPT‑4o, Gemini) permitirá descomposiciones guiadas por texto: “dame todas las botellas azules” y recibir los recortes correspondientes. La integración con generación de imágenes posibilitará modificar solo partes específicas de una escena usando difusión controlada por máscaras.
Para el profesional, esto significa que la descomposición se convertirá en un commodity tan simple como escribir una frase. Las plataformas que hoy ofrecen endpoints, como HolaGPT, evolucionarán hacia asistentes visuales interactivos. La barrera de entrada desaparece, y el valor se desplaza hacia cómo aplicas esa capacidad en tu negocio: automatizar catálogos, analizar defectos, mejorar la experiencia de usuario en apps o crear herramientas educativas interactivas.