Detección de Bordes en Imágenes: Guía Completa para Programadores
Desde los fundamentos hasta la implementación con Python y OpenCV
Por Jose Luis Rueda · 10 min lectura · 2026-07-23
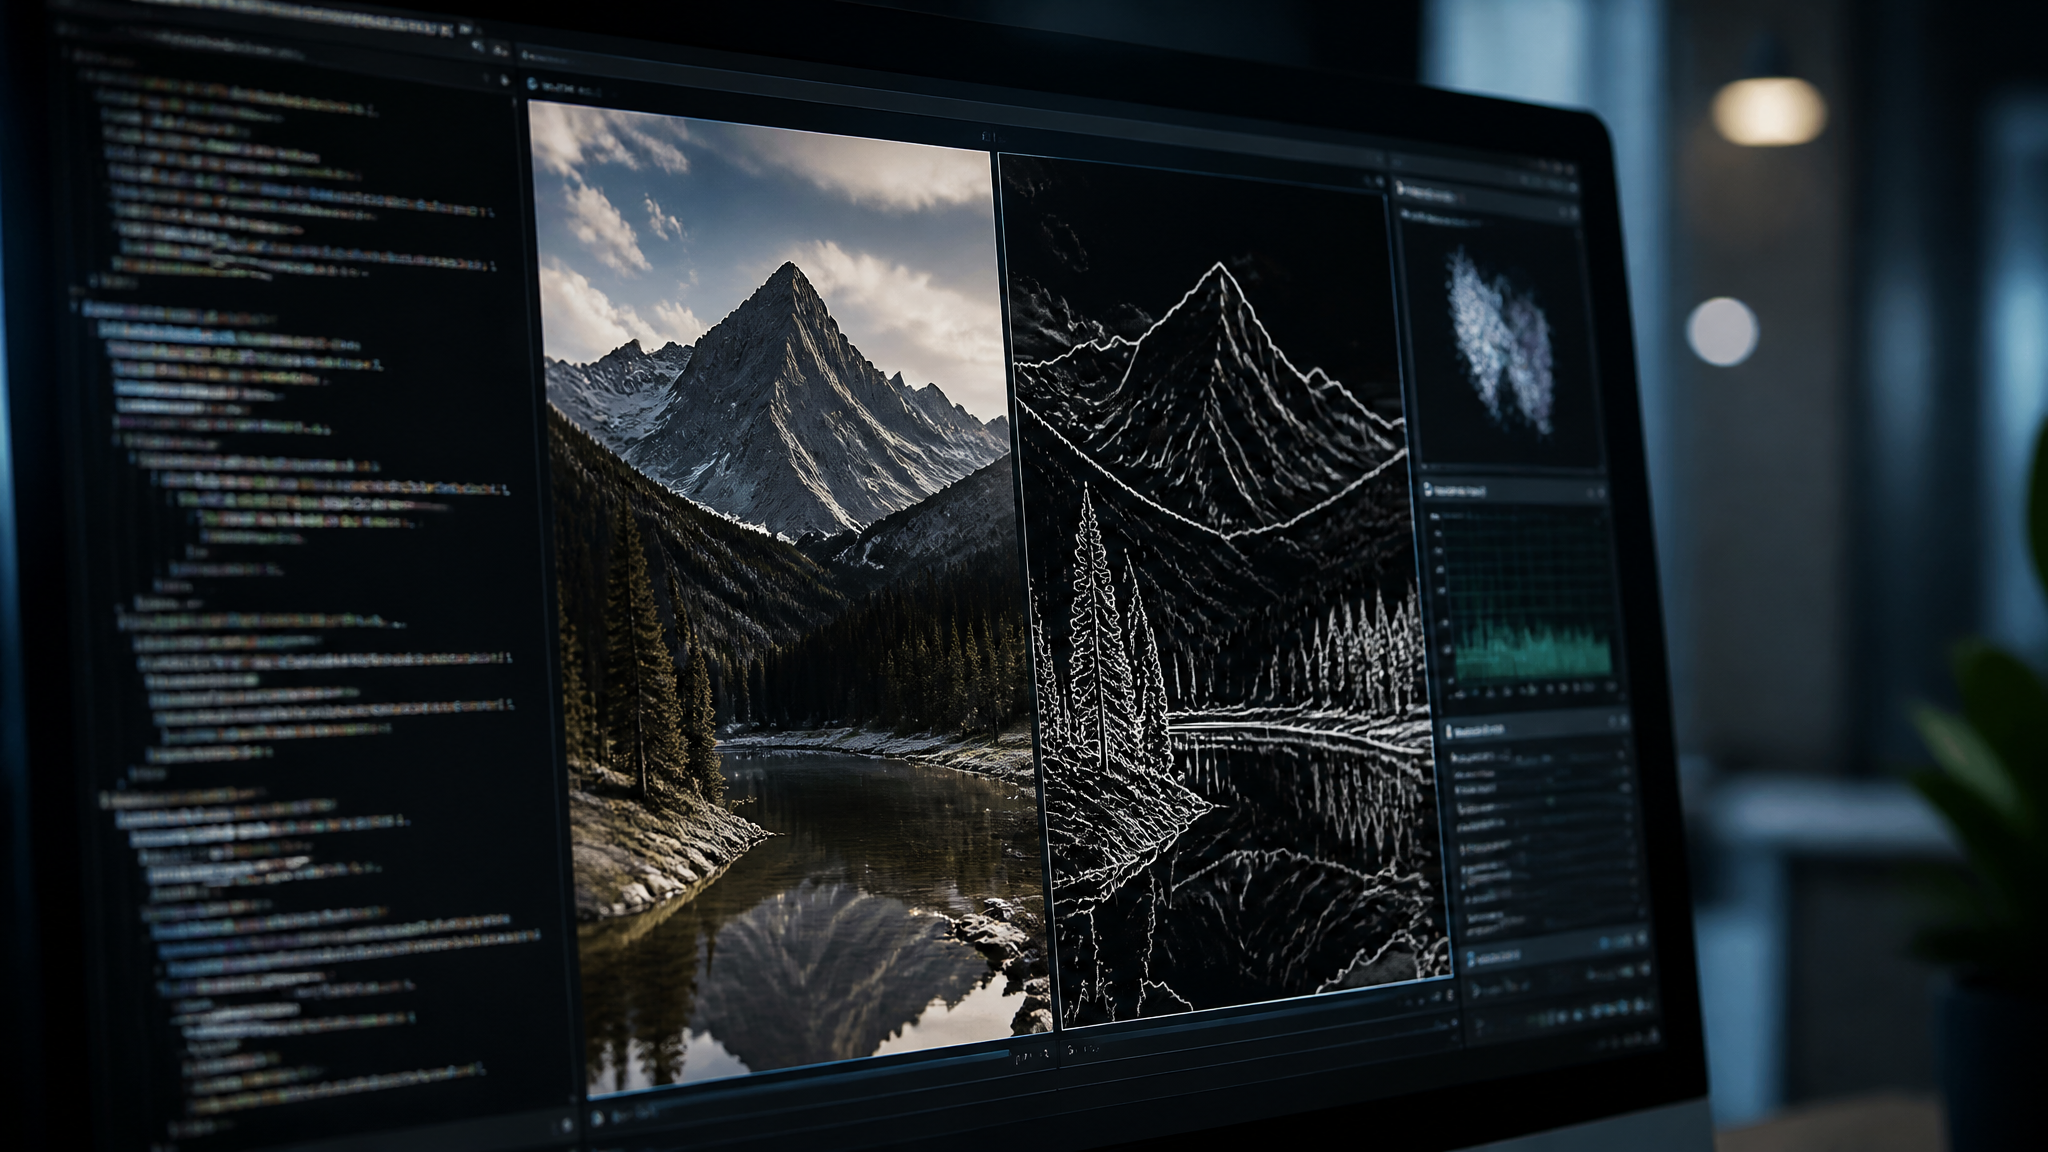
Cada imagen digital es una matriz de números. Los píxeles se organizan en filas y columnas, y entre ellos, las transiciones abruptas de intensidad dibujan todo lo que vemos: objetos, texturas, siluetas. Detectar esos cambios es una de las tareas más antiguas y fundamentales del procesamiento de imágenes. Los bordes son las fronteras que separan regiones, y extraerlos con precisión marca la diferencia entre una aplicación de visión artificial que funciona y una que falla.
Esta guía aborda la detección de bordes desde un enfoque práctico. Explicamos los operadores clásicos como Sobel o Prewitt, profundizamos en el algoritmo de Canny y mostramos cómo implementarlos con Python y OpenCV. No importa si trabajas en control de calidad, robótica o análisis de documentos: entender cómo encontrar los límites en una imagen te dará una ventaja técnica real.
El código que verás aquí se puede ejecutar en cualquier entorno con OpenCV instalado. Además, herramientas como HolaGPT pueden ayudarte a generar fragmentos de código, depurar parámetros o adaptar estos ejemplos a tu stack específico. Vamos directo al núcleo de la detección de bordes.
¿Qué es exactamente la detección de bordes?
En términos simples, un borde es una discontinuidad en la intensidad de una imagen. Si tomas una foto en escala de grises, un borde aparece donde el valor de los píxeles cambia drásticamente en una dirección espacial. Matemáticamente, estos cambios se modelan con derivadas. El gradiente de la imagen te dice la magnitud y dirección del cambio más rápido.
Los bordes no son líneas perfectas. Una imagen real tiene ruido, sombras y transiciones suaves. Por eso los algoritmos de detección buscan máximos locales del gradiente, aplicando filtros que amplifican las diferencias. La salida típica es una imagen binaria donde los píxeles blancos marcan los bordes y los negros el resto.
Dos conceptos clave: magnitud del gradiente (qué tan fuerte es el cambio) y orientación (en qué dirección ocurre). Con esa información puedes extraer contornos, reducir la dimensionalidad de los datos o alimentar un clasificador.
Importancia en la visión artificial moderna
La detección de bordes es la etapa de preprocesamiento más común en pipelines de visión. Antes de reconocer objetos o segmentar regiones, necesitas aislar las estructuras relevantes. Los bordes proporcionan la silueta de los elementos, eliminando texturas internas y manteniendo la forma.
Aplicaciones cotidianas: sistemas de inspección industrial detectan fisuras comparando bordes, los lectores de matrículas identifican caracteres mediante contornos, y la realidad aumentada superpone gráficos alineando bordes de superficies. En robótica, los bordes ayudan a estimar la profundidad y la geometría del entorno.
Incluso las redes neuronales convolucionales aprenden filtros que, en sus primeras capas, se comportan como detectores de bordes. Así que comprender los métodos clásicos te prepara para entender qué sucede dentro de una CNN. No es conocimiento obsoleto, es la base.
Tipos de bordes y cómo se forman en una imagen
Según la transición de intensidad, los bordes se clasifican en tres tipos principales:
- Bordes escalón: cambio brusco de un valor bajo a uno alto (o viceversa) en un solo píxel o muy pocos. Es el ideal en imágenes sintéticas, pero en el mundo real aparece suavizado por el desenfoque.
- Bordes de rampa: transición gradual a lo largo de varios píxeles. Es común cuando hay sombras o superficies curvas.
- Bordes de techo: pico de intensidad rodeado de valores más bajos. Se ve en líneas finas, como un cable sobre un fondo uniforme.
Cada tipo responde distinto a los operadores de derivada. Un borde escalón produce un pico en la primera derivada, mientras que uno de techo genera un cruce por cero en la segunda derivada. Elegir el filtro adecuado depende de la naturaleza de la imagen y del ruido presente.
Operadores clásicos: Sobel, Prewitt y Roberts
Los primeros detectores se basan en convoluciones con máscaras pequeñas. La idea es recorrer la imagen con un kernel que calcula la derivada en dirección horizontal y vertical, y luego combina ambas para obtener el gradiente.
Operador Sobel: utiliza kernels de 3x3 que dan más peso a los píxeles cercanos al centro, lo que suaviza ligeramente la respuesta. Es robusto frente al ruido gaussiano moderado. Los kernels típicos son:
Gx = [[-1, 0, 1], [-2, 0, 2], [-1, 0, 1]]
Gy = [[-1, -2, -1], [0, 0, 0], [1, 2, 1]]
La magnitud del gradiente se obtiene con sqrt(Gx² + Gy²) y la orientación con la arcotangente.
Prewitt: similar a Sobel pero sin ponderación central. Los kernels son:
Gx = [[-1, 0, 1], [-1, 0, 1], [-1, 0, 1]]
Gy = [[-1, -1, -1], [0, 0, 0], [1, 1, 1]]
Es más sensible al ruido pero más simple computacionalmente.
Roberts Cross: usa máscaras de 2x2 para calcular diferencias diagonales. Muy rápido pero muy sensible al ruido. Los kernels:
Gx = [[1, 0], [0, -1]]
Gy = [[0, 1], [-1, 0]]
En la práctica, Sobel domina por su balance entre respuesta y complejidad. Con OpenCV puedes aplicarlo con cv.Sobel() o usando cv.filter2D().
El detector de Canny: el estándar de la industria
Propuesto en 1986 por John Canny, su algoritmo sigue siendo el más utilizado para detección de bordes precisa y confiable. Cumple tres criterios:
- Buena detección: minimizar falsos positivos y falsos negativos.
- Buena localización: el borde marcado debe estar lo más cerca posible del borde real.
- Respuesta única: un solo borde por cada borde real.
El proceso consta de cinco etapas:
1. Reducción de ruido
Aplica un filtro Gaussiano para suavizar la imagen y eliminar detalles finos que generarían bordes falsos. La desviación estándar (σ) controla el grado de suavizado.
2. Cálculo del gradiente
Usa Sobel (u otro) para obtener magnitud y dirección del gradiente en cada píxel. La dirección se redondea a cuatro ángulos: 0°, 45°, 90°, 135°.
3. Supresión no máxima
Para cada píxel, compara su magnitud con los dos vecinos en la dirección del gradiente. Si no es el máximo local, se descarta. Esto adelgaza los bordes a un píxel de ancho.
4. Umbralización por histéresis
Se definen dos umbrales: uno alto y uno bajo. Los píxeles con magnitud superior al umbral alto se consideran bordes seguros. Los que están por debajo del umbral bajo se descartan. Los que están entre ambos se conservan solo si están conectados a un borde seguro.
5. Seguimiento de bordes
Se recorre la imagen comprobando conectividad (8-vecinos) para unir los bordes débiles a los fuertes. Así se evitan interrupciones.
En OpenCV, todo esto se resume en una sola línea:
edges = cv.Canny(image, threshold1, threshold2)Elegir bien los umbrales es la clave del éxito. Una regla práctica: el umbral bajo debe ser un tercio del umbral alto. Para muchas escenas, valores de 100 y 200 funcionan bien si la imagen está normalizada.
Implementación práctica con Python y OpenCV
Vamos a escribir un script completo que carga una imagen, aplica Canny, Sobel y visualiza los resultados. Necesitas instalar OpenCV y Matplotlib:
pip install opencv-python matplotlibCódigo:
import cv2 as cv
import matplotlib.pyplot as plt

# Leer imagen y convertir a grises
img = cv.imread('ejemplo.jpg')
gray = cv.cvtColor(img, cv.COLOR_BGR2GRAY)

# Aplicar Canny
edges_canny = cv.Canny(gray, 100, 200)

# Aplicar Sobel en X e Y
sobel_x = cv.Sobel(gray, cv.CV_64F, 1, 0, ksize=3)
sobel_y = cv.Sobel(gray, cv.CV_64F, 0, 1, ksize=3)
# Calcular magnitud
sobel_mag = cv.magnitude(sobel_x, sobel_y)
# Normalizar a 8 bits
sobel_mag = cv.normalize(sobel_mag, None, 0, 255, cv.NORM_MINMAX, cv.CV_8U)

# Mostrar resultados
fig, axes = plt.subplots(1, 3, figsize=(12,4))
axes[0].imshow(cv.cvtColor(img, cv.COLOR_BGR2RGB))
axes[0].set_title('Original')
axes[1].imshow(sobel_mag, cmap='gray')
axes[1].set_title('Sobel Magnitud')
axes[2].imshow(edges_canny, cmap='gray')
axes[2].set_title('Canny')
for ax in axes:
    ax.axis('off')
plt.tight_layout()
plt.show()
Guarda el script y ejecuta. Notarás que Sobel produce bordes más gruesos y algo de ruido, mientras Canny entrega líneas finas y limpias. Si la imagen tiene mucho ruido, suaviza antes de aplicar Sobel con cv.GaussianBlur().
Para aplicaciones en video, la lógica es similar: capturas frame a frame y aplicas el detector. Con Canny, el costo computacional es bajo y puedes procesar 30 fps en una laptop sin problemas.
Ajuste de parámetros y buenas prácticas
No hay valores universales. Los umbrales de Canny dependen del rango dinámico de tu imagen. Una imagen con bajo contraste necesitará umbrales más bajos. Un buen flujo de trabajo incluye:
- Analizar el histograma: identifica el rango de intensidades de los bordes potenciales con un gradiente previo.
- Prueba interactiva: usa sliders con OpenCV (
cv.createTrackbar()) para ajustar umbrales en tiempo real. - Preprocesamiento adaptativo: ecualizar el histograma con CLAHE (
cv.createCLAHE()) mejora el contraste local y facilita la detección.
Para Sobel, el tamaño del kernel afecta la suavidad. Ksize=3 respeta detalles finos; ksize=5 o 7 suaviza más y reduce el ruido, pero emborrona bordes débiles.
En producción, encapsula la lógica en una función con parámetros configurables. HolaGPT puede asistirte generando ese wrapper automáticamente: solo describe la entrada y salida deseada y obtendrás un código modular listo para integrar en tu proyecto.
Aplicaciones reales más allá del ejemplo académico
La detección de bordes no es solo un ejercicio de libro de texto. Veamos casos concretos:
- OCR y lectura de documentos: se detectan bordes para encontrar la región del documento, enderezar la perspectiva y luego extraer texto con Tesseract.
- Medición dimensional: en fábricas, se usa Canny para localizar bordes de piezas y calcular longitudes con precisión subpíxel.
- Detección de carriles: en conducción autónoma, se filtran bordes con orientación cercana a vertical para aislar las marcas viales.
- Segmentación de objetos: los bordes sirven como inicialización para algoritmos como watershed o Graph Cut.
- Compresión de imágenes: codificadores como JPEG2000 usan detección de bordes para preservar contornos nítidos en tasas bajas de bits.
En todos estos casos, la calidad del detector impacta directamente el rendimiento del sistema. Por eso dedicar tiempo a ajustar parámetros no es opcional.
Limitaciones y consideraciones importantes
La detección de bordes no es magia. Tiene fallas sistemáticas:
- Sensibilidad al ruido: los filtros de derivada amplifican el ruido de alta frecuencia. Un pre-suavizado excesivo sacrifica detalles reales.
- Bordes incompletos: en zonas de bajo contraste, Canny puede romper un borde continuo. La histéresis ayuda, pero no es infalible.
- Iluminación no uniforme: un gradiente de luz puede saturar la detección en unas regiones y dejarla ciega en otras. La ecualización local mitiga esto.
- Texturas como falsos bordes: superficies con patrones repetitivos (madera, tela) generan una maraña de líneas. Se necesitan etapas posteriores de filtrado morfológico.
Para tareas de alto nivel, los bordes crudos rara vez son el producto final. Se encadenan con operaciones como dilatación, erosión, o transformada de Hough para encontrar formas geométricas. La integración con HolaGPT permite consultar cuál es la mejor estrategia según tu aplicación concreta, y recibir código adaptado.
Herramientas modernas y el rol de la IA
Hoy existen detectores de bordes basados en aprendizaje profundo, como HED (Holistically-Nested Edge Detection) o RCF (Richer Convolutional Features). Estos modelos predicen mapas de bordes con una calidad superior a Canny en escenas complejas, capturando contornos semánticos. Sin embargo, requieren GPU y conjuntos de datos anotados.
Para el 90% de las aplicaciones industriales, Canny sigue siendo suficiente. Su predictibilidad y bajo costo computacional lo convierten en la opción por defecto. Además, al ser determinista, cada píxel está justificado matemáticamente, algo que los modelos de caja negra no ofrecen.
Plataformas como HolaGPT ayudan a cerrar la brecha: puedes describir el problema en lenguaje natural, obtener una implementación completa con OpenCV y explicaciones línea por línea, y luego iterar sobre ella. Así reduces el tiempo de desarrollo de horas a minutos.