Identifica oportunidades de multihilo y multiproceso en tu código
Una guía técnica para encontrar y explotar el paralelismo oculto en tus aplicaciones
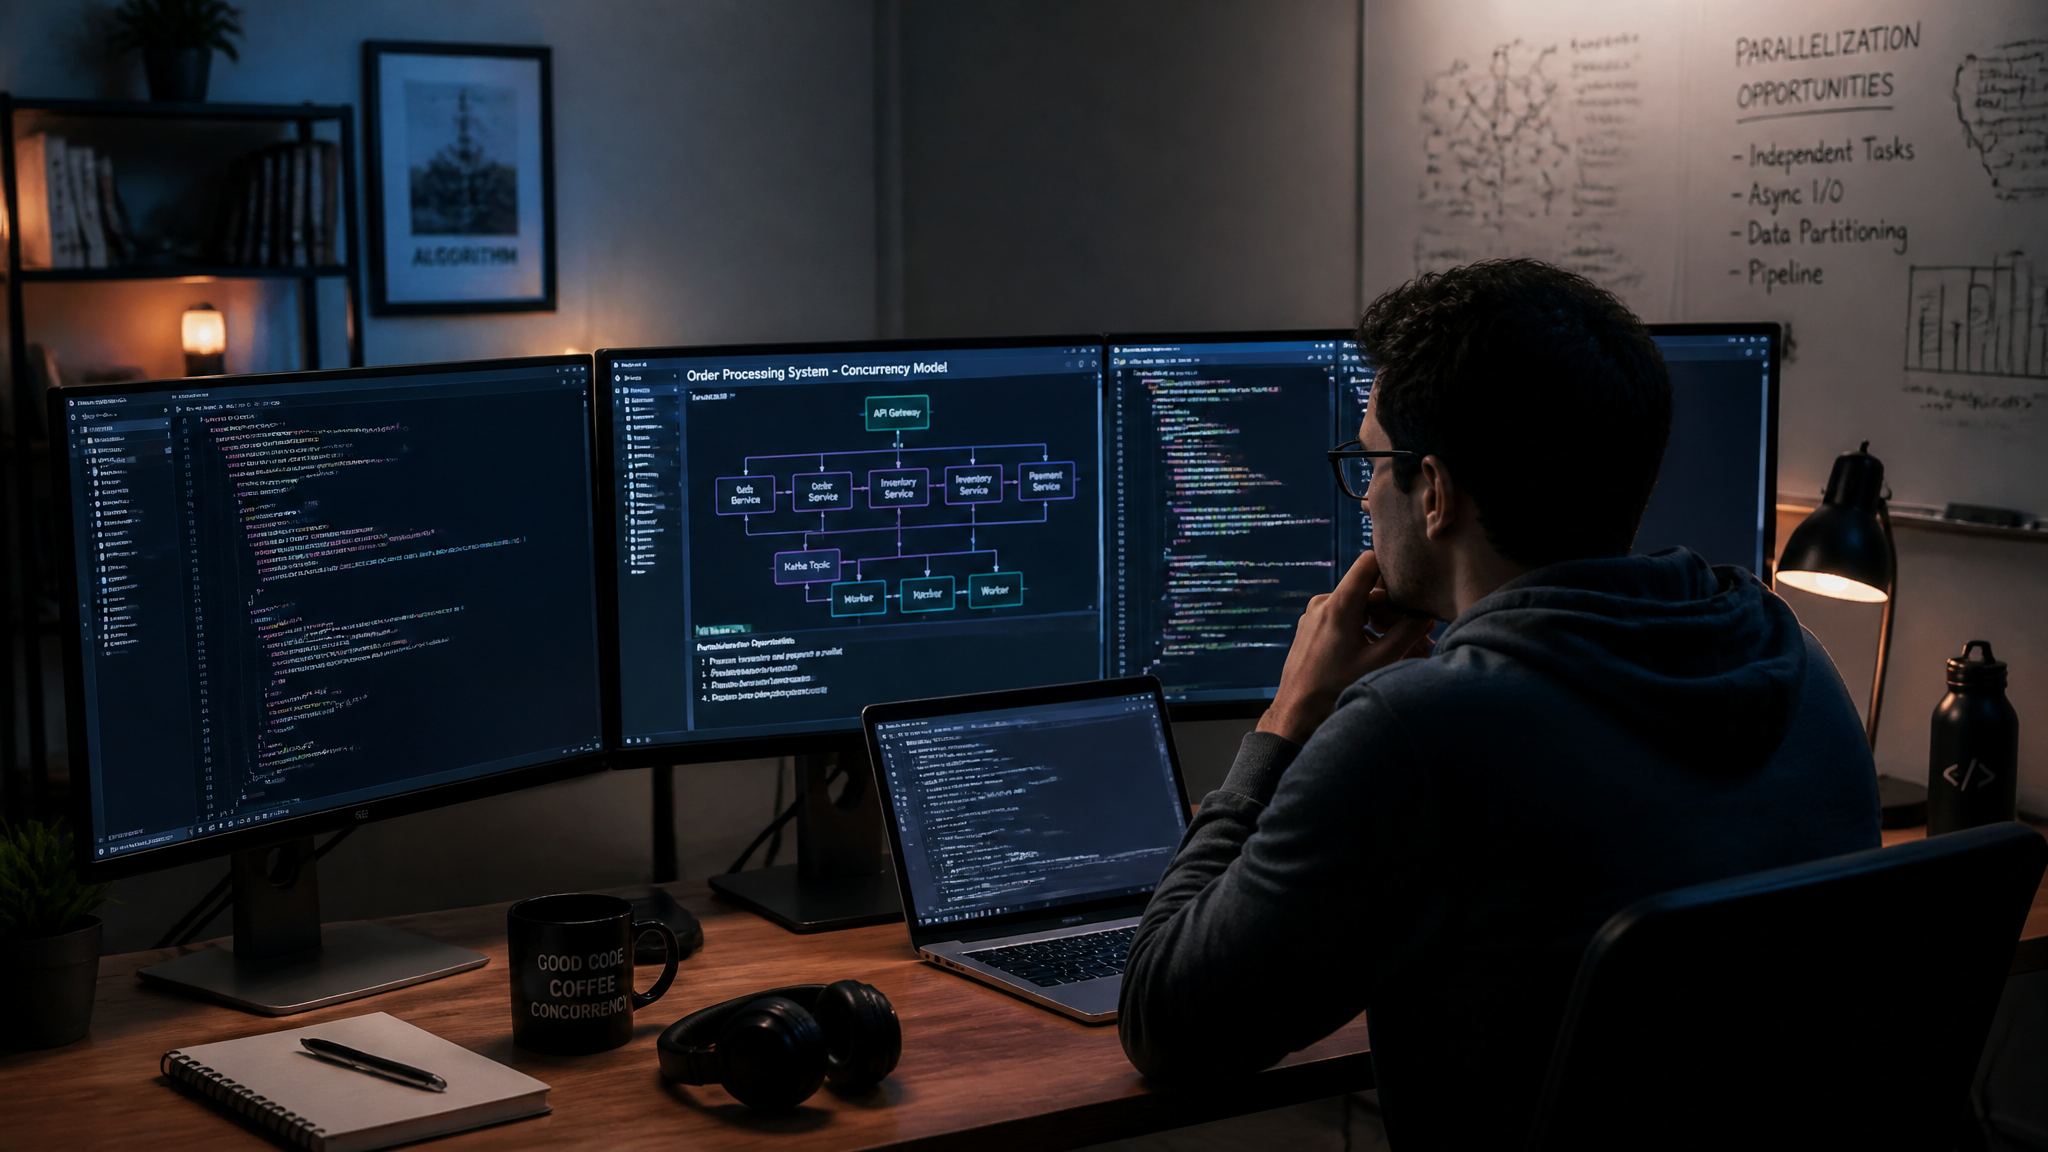
Por Jose Luis Rueda · 12 min lectura · 2026-07-26
El rendimiento de una aplicación no depende solo de la velocidad del hardware. La mayoría de los sistemas modernos tienen múltiples núcleos esperando trabajo. Sin embargo, muchos programas los desaprovechan al ejecutar todo en un solo hilo. Identificar oportunidades de paralelización es una habilidad que separa el código funcional del código de alto rendimiento.
El multihilo y el multiproceso no son magia. Aplicarlos mal introduce carreras de datos, bloqueos y una complejidad que puede volver el código inmantenible. Pero si se analizan los patrones correctos y se usa el perfilado adecuado, se puede acelerar drásticamente el software sin sacrificar estabilidad.
En este artículo verás un proceso sistemático para detectar dónde, cuándo y cómo paralelizar. Abordaremos desde el análisis de la carga de trabajo hasta la implementación en Python, Java y C++, incluyendo herramientas de profiling, patrones de diseño concurrente y errores típicos que cometen incluso desarrolladores experimentados.
Entiende la diferencia entre multihilo y multiproceso
Antes de buscar oportunidades, aclara los conceptos. El multihilo (threading) ejecuta múltiples tareas dentro del mismo proceso compartiendo memoria. Es ligero y rápido para comunicación interna, pero peligroso: cualquier acceso no sincronizado a datos compartidos puede causar corrupción silenciosa. El multiproceso (multiprocessing) lanza procesos separados con memoria aislada. La comunicación es más costosa (serialización, pipes), pero elimina las carreras de datos por diseño. La elección depende del problema.
En Python, el Global Interpreter Lock (GIL) limita el multihilo para tareas CPU-bound. Por eso, el multiproceso suele ser la vía para paralelismo real. En Java, los hilos son nativos y comparten objetos en el heap; la gestión se apoya en el paquete java.util.concurrent. En C++, std::thread ofrece control fino, pero necesita cuidado extremo con la gestión de memoria. Conocer las capacidades de tu stack tecnológico es el primer filtro para identificar oportunidades aprovechables.
Tipos de tareas que se benefician de la concurrencia
No todo el código es paralelizable. Las tareas se dividen en dos grandes grupos: CPU-bound e I/O-bound. Las primeras saturan la CPU (cálculos matemáticos, compresión, videoprocesamiento). Las segundas esperan operaciones de entrada/salida (red, disco, bases de datos). Las tareas I/O-bound se benefician enormemente del multihilo incluso en Python, porque los hilos pueden dormirse en espera sin bloquear a otros. Las CPU-bound requieren multiproceso para escalar más allá de un núcleo.
Además, existen las tareas embarrassingly parallel (vergonzosamente paralelas): trabajos independientes que no necesitan coordinación. Ejemplos: procesar un lote de imágenes, transformar filas de un DataFrame, enviar correos electrónicos masivos. Si cada unidad de trabajo no depende de otra, has encontrado la oportunidad más limpia. Solo divide los datos y lanza workers.
Señales de que tu código necesita paralelismo
Estos síntomas indican que puedes estar ejecutando todo en un solo hilo sin necesidad:
- Uso de CPU bajo en máquina multicore mientras el programa se ejecuta con lentitud. Indica que solo se usa un núcleo.
- Operaciones de I/O secuenciales: consultas a base de datos una tras otra sin relación de dependencia.
- Bucles con procesamiento independiente: for each item sin estado compartido entre iteraciones.
- Callbacks o eventos que se procesan en fila, cuando podrían manejarse en paralelo.
- Latencia en interfaces de usuario porque el hilo principal hace trabajo pesado.
Si detectas alguno de estos patrones, el siguiente paso es medir y confirmar con herramientas de profiling.
Herramientas para detectar cuellos de botella
No paralelices a ciegas. Primero perfilá el código. En Python, cProfile y line_profiler muestran exactamente dónde se consume tiempo. En Java, VisualVM o JProfiler revelan hotspots y contención de hilos. En C/C++, perf y Valgrind (callgrind) son esenciales. También usa métricas de sistema (top, htop, Activity Monitor) para ver la utilización de núcleos.
La clave es enfocarse en las funciones donde el programa pasa la mayor parte del tiempo (regla 80/20). A veces, un pequeño bloque de código es el responsable del 90% de la latencia. Paralelizar esa porción puede dar un salto de rendimiento con esfuerzo mínimo. Una vez identificada la región crítica, analiza las dependencias de datos: ¿las iteraciones del bucle escriben en estructuras compartidas? ¿Leen datos que cambian durante la ejecución? Si no hay efectos colaterales, puedes aplicar un map concurrente.
Patrones de diseño para paralelizar
Estos patrones te ayudan a transformar código secuencial en concurrente sin reinventar la rueda:
MapReduce / Fork-Join
Divide un conjunto de datos en fragmentos, procesa cada fragmento en paralelo y combina resultados. Ideal para agregaciones, filtrados y transformaciones a gran escala. En Java, el framework ForkJoinPool automatiza la división recursiva. En Python, concurrent.futures.ProcessPoolExecutor simplifica el map paralelo.
Productor-Consumidor
Productores generan tareas y las encolan, consumidores las procesan. Útil cuando la generación de trabajo es más rápida que su procesamiento, o cuando hay que limitar recursos. En Python, Queue del módulo threading o multiprocessing facilita la implementación. En Java, BlockingQueue y ExecutorService son las herramientas base.
Pipeline
Varias etapas de procesamiento pueden ejecutarse en paralelo si cada una opera sobre datos diferentes al mismo tiempo. Similar a una cadena de montaje. Cada etapa es un hilo o proceso que recibe de una cola y entrega a la siguiente. Aumenta throughput aunque la latencia individual no mejore.
Actor Model
Cada actor tiene estado privado y se comunica por mensajes. No hay estado compartido, eliminando carreras. Akka en Java/Scala y Pykka en Python implementan este modelo. Es muy potente para sistemas distribuidos y aplicaciones con alta concurrencia.
Ejemplo práctico: procesamiento de imágenes en Python
Partimos de un script secuencial que redimensiona 100 imágenes:
for filename in os.listdir('input'):
    img = Image.open(os.path.join('input', filename))
    img = img.resize((800, 600))
    img.save(os.path.join('output', filename))
Es un caso embarazosamente paralelo. Cada imagen es independiente. Para acelerarlo con multiproceso:
from concurrent.futures import ProcessPoolExecutor

def process_image(filename):
    img = Image.open(os.path.join('input', filename))
    img = img.resize((800, 600))
    img.save(os.path.join('output', filename))

with ProcessPoolExecutor() as executor:
    executor.map(process_image, os.listdir('input'))
Con esto, el tiempo se reduce casi linealmente con el número de núcleos. Fácil, seguro y sin compartir estado.
Caso de estudio: servidor web multihilo
Un servidor TCP que atiende conexiones secuencialmente no escala. Cada petición bloquea a las demás. La solución: un hilo por conexión o un pool de hilos. En Python, socketserver.ThreadingMixIn permite crear servidores multihilo con pocas líneas. En Java, java.nio con Selectors y thread pools ofrece alto rendimiento sin un hilo por conexión. La oportunidad de paralelismo aquí es clara: las conexiones son independientes. Sin embargo, el acceso a recursos compartidos (sesiones, base de datos) debe sincronizarse. Aquí emerge la complejidad.
Un patrón común es usar un pool de workers que reciben las peticiones. Los workers pueden ejecutar en paralelo mientras el hilo principal solo acepta conexiones. Si un worker necesita actualizar una caché, usa synchronized (Java) o Lock (Python) para evitar condiciones de carrera.
El papel de HolaGPT en la identificación de paralelismo
Analizar manualmente un codebase grande en busca de oportunidades es tedioso. Herramientas de análisis estático como ThreadSanitizer o SpotBugs detectan algunos errores de concurrencia, pero no sugieren mejoras. Aquí entra HolaGPT: puedes pegar fragmentos de código y preguntar: "¿Este bucle es paralelizable?", "¿Hay riesgo de condición de carrera aquí?" o "Convierte este código secuencial a paralelo usando ExecutorService". HolaGPT evaluará las dependencias y propondrá alternativas seguras, explicando el razonamiento.
Además, HolaGPT puede generar tests de estrés en concurrencia para validar que tu implementación paralela no introduce errores sutiles. Por ejemplo, solicitar: "Genera un test en Java que lance 100 hilos incrementando un contador compartido con AtomicInteger para verificar atomicidad". Esto acelera la validación y reduce los bugs en producción.
Errores comunes al paralelizar
Estos fallos pueden tirar por tierra las ganancias de rendimiento:
- Exceso de hilos: más hilos que núcleos solo añade overhead de cambio de contexto, especialmente en tareas CPU-bound. Usa pools de tamaño controlado (Runtime.getRuntime().availableProcessors()).
- Falsa compartición: en estructuras de datos donde diferentes hilos escriben en posiciones cercanas de memoria, se invalidan las líneas de caché entre núcleos continuamente, degradando el rendimiento. Usa padding o variables locales.
- Olvidar el overhead de coordinación: locks, barreras y comunicación entre procesos tienen coste. Si el trabajo por item es muy pequeño, la ganancia de paralelizar se pierde en la gestión. Mide antes y después.
- Bloqueos anidados: causan deadlocks difíciles de diagnosticar. Siempre adquiere locks en un orden fijo y utiliza timeouts.
- No considerar el GIL: en Python, lanzar hilos para tareas CPU-bound no acelera nada; utiliza multiprocessing o compilación con Cython (sin GIL) para liberar el bloqueo.
Carga de trabajo mixta y balanceo
En aplicaciones reales, las tareas suelen ser híbridas: parte I/O y parte CPU. Una estrategia puede combinar multihilo para I/O y multiproceso para CPU, con colas intermedias. Por ejemplo, un scraper que descarga páginas (I/O) y luego parsea HTML (CPU). Los descargadores pueden ser hilos (o async) porque esperan red; los parseadores, procesos porque consumen CPU. Entre ambos, una cola segura (multiprocessing.Queue) equilibra la carga.
El balanceo es crucial: si los productores son más rápidos que los consumidores, la cola crecerá sin límite. Implementa backpressure limitando el tamaño de la cola y haciendo que los productores esperen (put con bloqueo). Monitorea la tasa de procesamiento para ajustar el número de trabajadores.
Validación y testing de código concurrente
El comportamiento no determinista de los programas paralelos complica su testeo. Errores como carreras pueden aparecer solo bajo ciertas condiciones de timing. Aparte de los tests unitarios tradicionales, necesitas tests de estrés y herramientas como:
- Concurrency Unit Tests: lanzar muchos hilos que ejecutan la operación crítica y verificar invariantes.
- ThreadSanitizer (en C/C++/Go): detecta data races en tiempo real.
- Java Pathfinder: exploración sistemática de estados de hilos.
- Chaos Testing: introducir retardos aleatorios con sleep() o instrumentación para forzar condiciones extremas.
HolaGPT puede ayudarte a diseñar estos tests: "Escribe un test de concurrencia en Python para una función que retira dinero de una cuenta bancaria simulando múltiples hilos simultáneos." De esta manera, agilizas la cobertura de casos extremos.
Alternativas modernas: async/await y corrutinas
Antes de adoptar multihilo pesado, evalúa si async/await resuelve tu problema con menos overhead. Las corrutinas permiten manejar miles de operaciones I/O con un solo hilo, ideal para servidores web y networking. En Python, asyncio; en JavaScript, nativo; en Rust, async con tokio. Pero ojo: async no ayuda con CPU-bound, ahí sigues necesitando multiproceso o threads reales.
La decisión entre async y multihilo no es binaria. A veces un modelo híbrido,un pool de threads para código bloqueante y un event loop para I/O no bloqueante, produce la mejor combinación. Elegir la herramienta correcta requiere entender dónde pasa el tiempo tu programa.
Midiendo la mejora y cuándo no paralelizar
No siempre conviene paralelizar. Si la ganancia es marginal y la complejidad se dispara, el coste de mantenimiento futuro no se justifica. Calcula la aceleración teórica con la ley de Amdahl: si el 90% del tiempo está en la parte secuencial, por muchos núcleos que uses, la aceleración máxima es solo 10x. Si tu carga es inherentemente secuencial (algoritmos iterativos estrictos), el esfuerzo no tendrá retorno.
Documenta siempre el antes y el después: tiempo de ejecución, uso de CPU, memoria y líneas de código añadidas. Usa métricas de throughput (tareas/segundo) y latencia (percentil 95). Solo así sabrás si la paralelización fue exitosa o introdujo más problemas.
Empieza por las oportunidades más obvias: bucles independientes, operaciones I/O, solicitudes externas. Aplica patrones conocidos, testea agresivamente y mide. Con la práctica, detectar oportunidades de multihilo y multiproceso se convertirá en un reflejo profesional.